Foundry Labs / コミュニティから
保険金請求のAI:証拠を確認できる業務フローを設計する
目次
プロトタイプを超えて、なぜ保険AIは本番で躓くのか
保険の損傷評価にAIを使うなら、モデルの精度に加え、担当者が出力をどう確認し、例外にどう対応するかまで評価する必要がある。集計指標だけでは見えにくい誤りや、顧客ごとの業務の違いをどう捉えるかが、本番運用の設計課題になる。
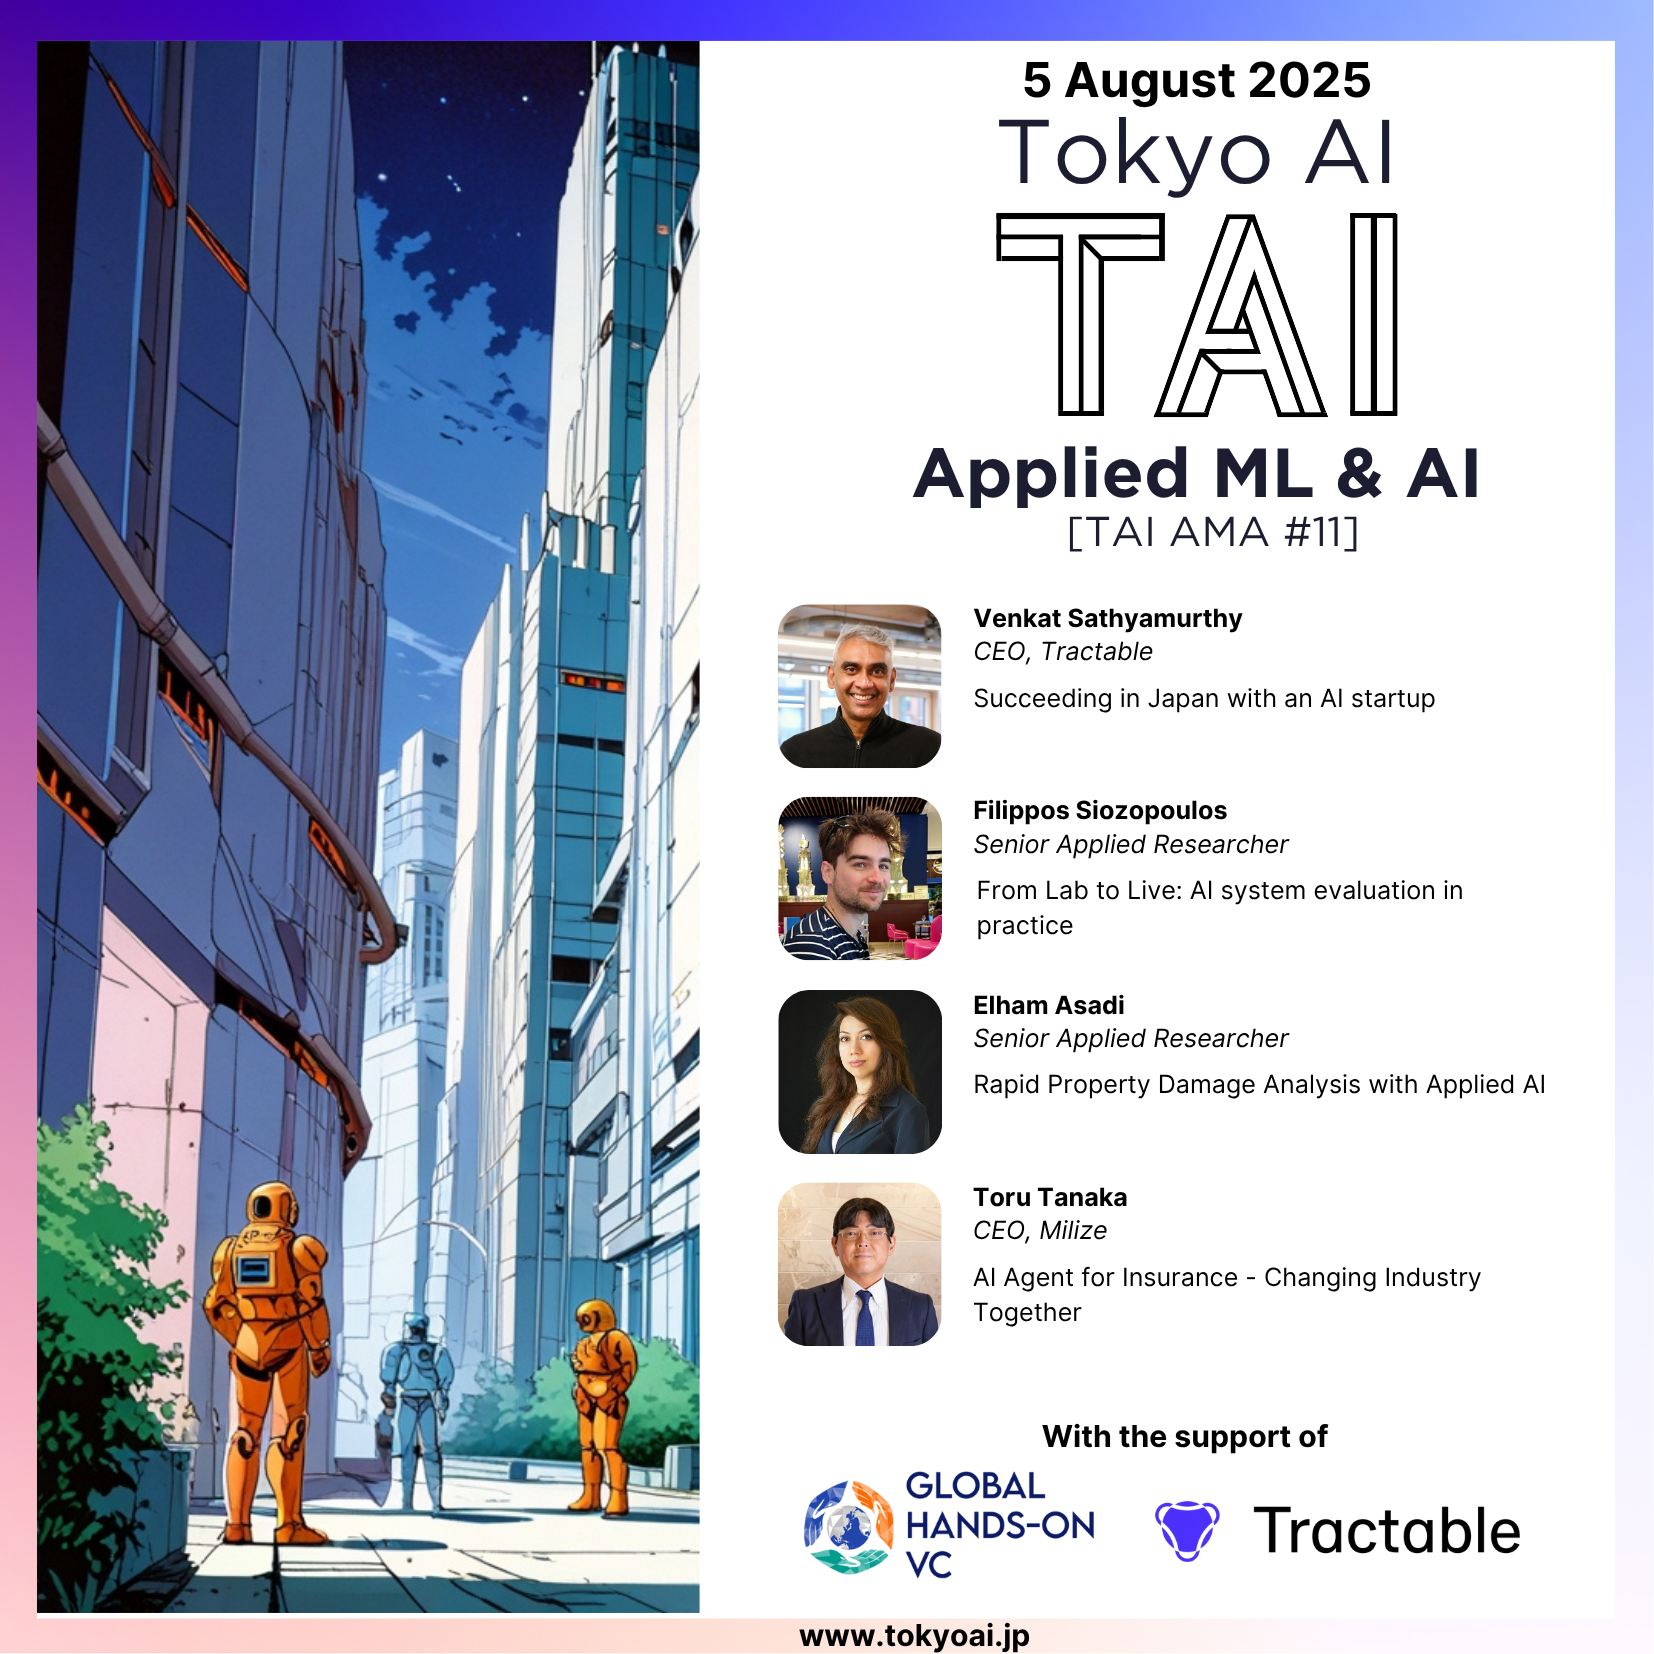
2025年8月5日、Tokyo AI(TAI)は東京都港区で「TAI AMA #11:AI x Insurance」を開催した。公開プログラムには、日本市場での企業向けAI展開、金融ワークフローへのマルチエージェント活用、物件損傷評価、本番AIの評価設計という4つのテーマが並んだ。本稿はTractableの応用研究チームが提示した評価手法を中心に整理する。その評価設計を、保険金請求の確認業務にどう生かせるかを考える。
イベント: TAI AMA #11:AI x Insurance 日時: 2025年8月5日(火)18:00〜21:00 JST 開催地: 東京都港区 主催: Tokyo AI(TAI)、GHOVC・Tractable協力 形式: 4講演+ネットワーキング 公開イベントページ: luma.com/pfq0owk3
評価を難しくするアーキテクチャの変化
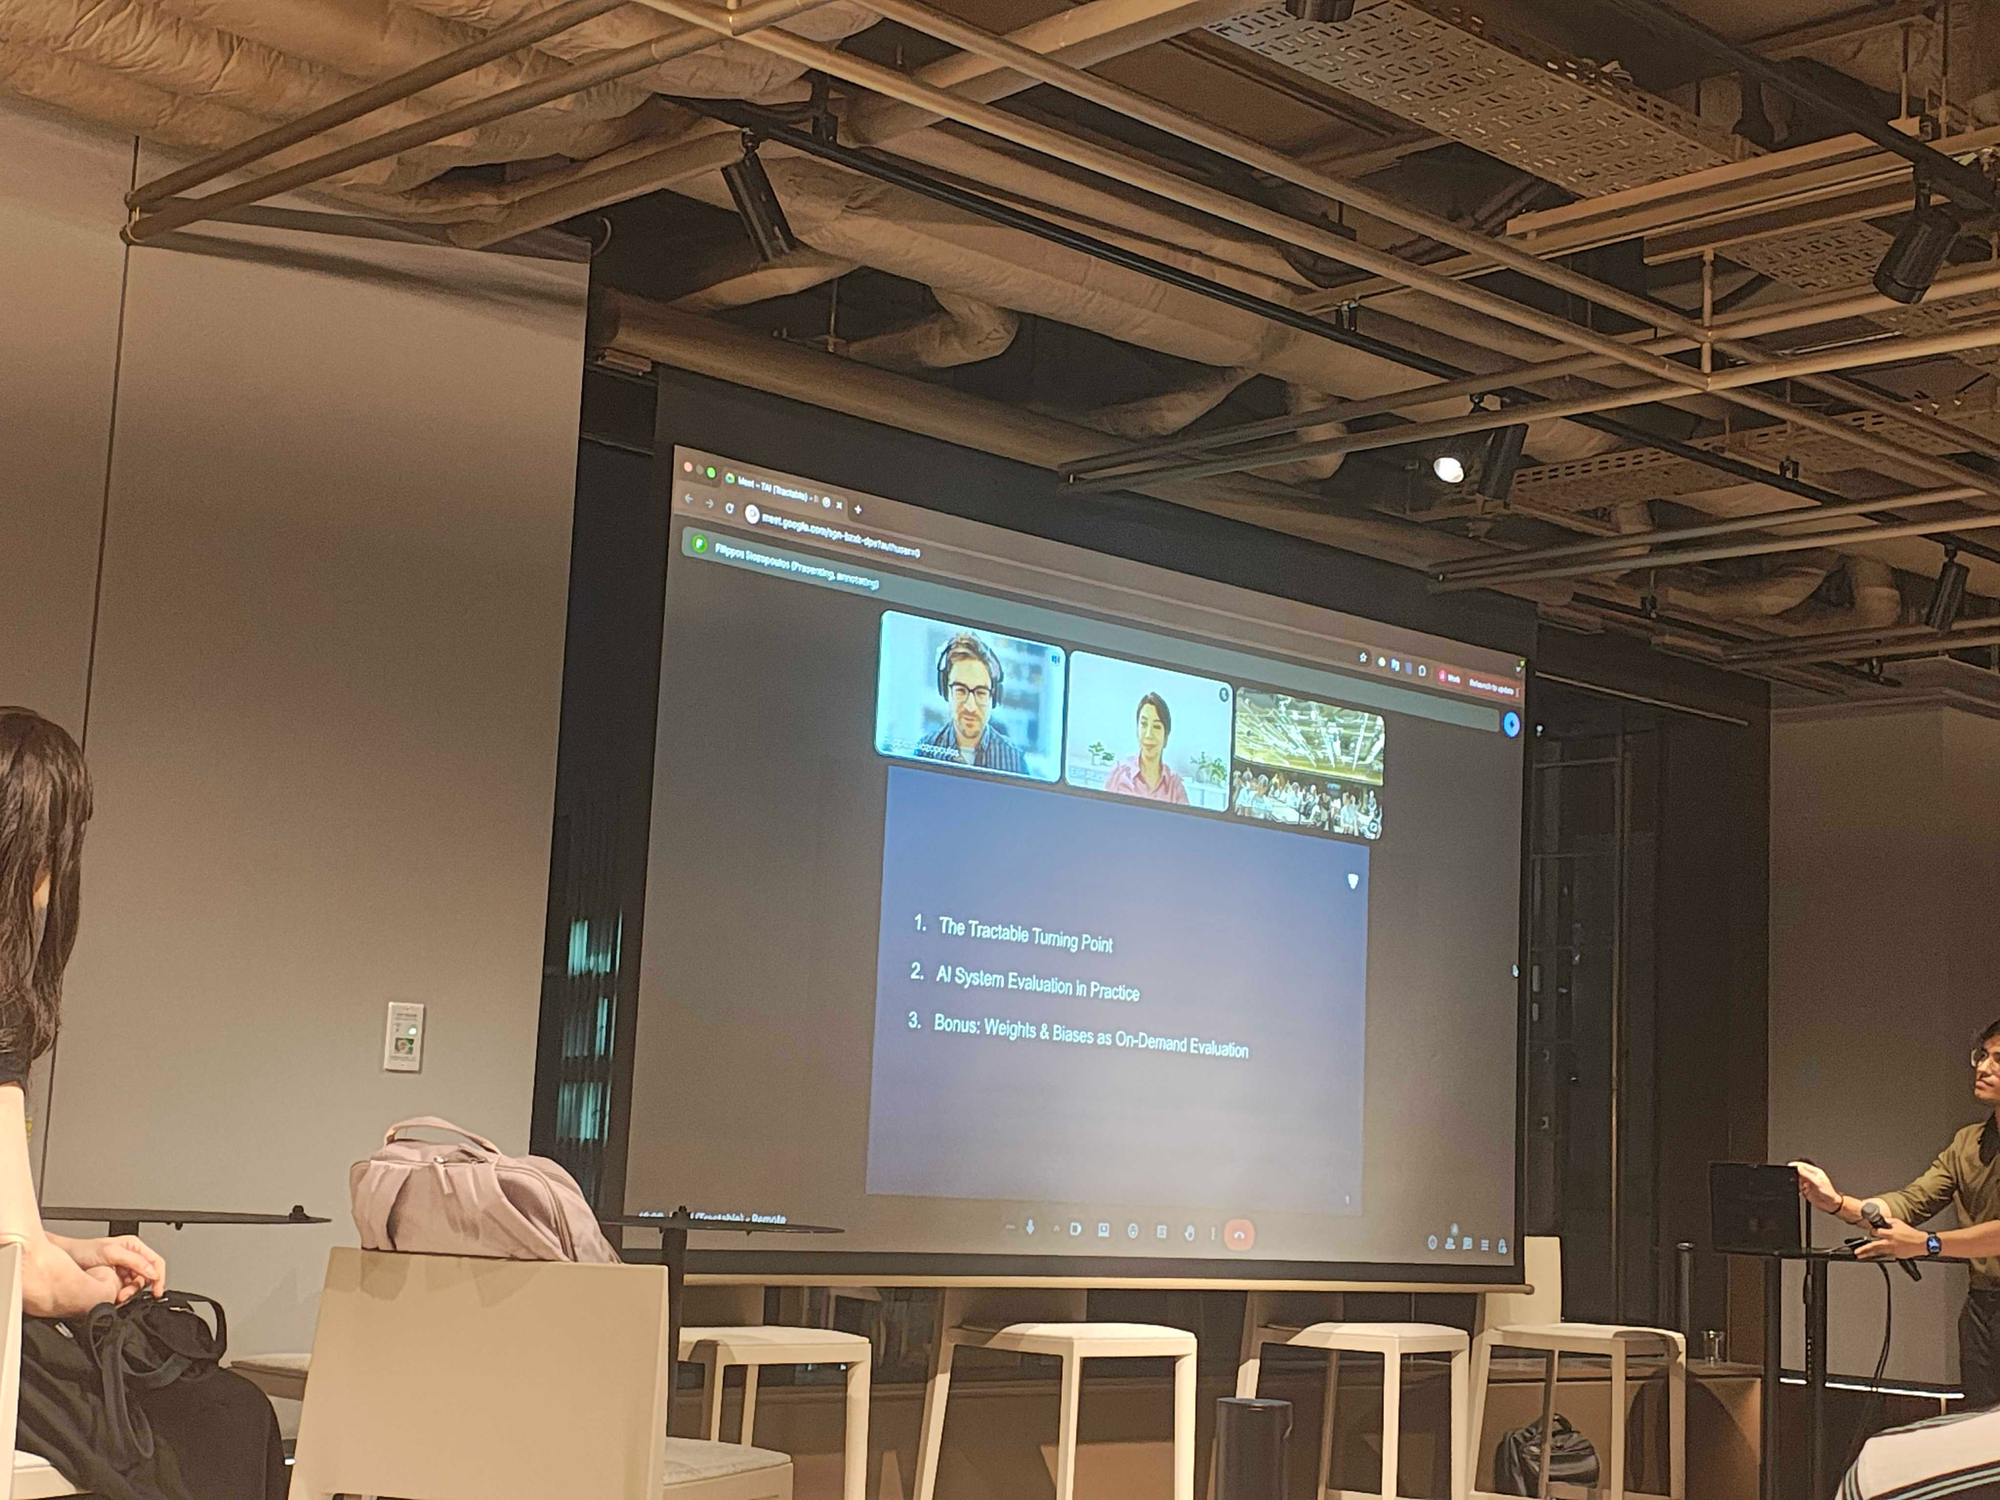
TractableのSenior Applied ResearcherであるFilippos(Fil)Siozopoulos氏は、AIシステムの成熟とともに評価がなぜ難しくなるのかを、アーキテクチャの変遷から説き起こした。
Tractableの初期本番システムはモノリシック設計だった。1つのモデルが多くのタスクをカバーし、新しいタスクを追加する場合はシステム全体を再学習する必要がある。このアプローチでは研究チームがクライアントや地域ごとに独立して作業できた上、イテレーションサイクルが遅いためアドホックな評価でも許容範囲だった。
現在の方向性はコンポーネント単位(component-wise)の設計だ。各モデルは1つのタスクに高度に特化し、あるモデルの出力が別のモデルの入力になる。研究の委任と集中が容易になる一方で、重大な依存関係が生まれる。Fil氏のスライドが示すように、あるコンポーネントへの変更は下流コンポーネントのパフォーマンスに影響するため、システム全体をエンドツーエンドで迅速に評価しGo/No-Go判断を下せる能力が不可欠になる。
モノリシックからコンポーネント単位への移行は保険特有の話ではない。単一モデルを超えて成長した本番AIシステムなら、同じ評価課題に直面する。「1箇所の変更が全体を改善したのか劣化させたのか」をどう確かめるかという問いは、業種を問わない。
高速なイテレーションを支える3つの原則
Fil氏の発表では、品質管理を保ちながら素早くイテレーションできるシステムを構築するための3つの指針が示された。
迅速な修正可能性(Rapid Correctability): システムのエラーを発生の初期段階で検出し、潜在的な修正をすぐに実行できる状態にする。定期的なレビューサイクルを待つのではなく、問題が起きたタイミングに近い形でフラグを立てられる評価インフラが必要になる。
スケーラビリティ(Scalability): システムとプロセスはクライアント数の増加に合わせてスケールしなければならない。保険の文脈では、クライアントや地域ごとに作り直すのではなく、異なる要件を収容できる単一の評価パイプラインが求められる。
効率的なデータ収集(Efficient Data Collection): 本番データをオンデマンドで取り出せる堅牢なストレージとともに、再利用可能なパイプラインを整備する。Fil氏のスピーカーノートが強調するように、クライアントが提供する初期データセットはあくまでブートストラップに過ぎない。本番データの継続的な収集と活用こそがシステムを洗練させる鍵であり、差別化の源泉となる。
これらの原則は概念としては明快だが、実現には具体的なインフラ要件が伴う。迅速な修正可能性はツールの整備なしには実現できない。スケーラビリティには評価プロファイルの設計が必要だ。効率的なデータ収集は問題が起きてから組み立てるのではなく、モデルのパイプラインと並行して維持されなければならない。
評価フレームワークの3軸:スコープ、手法、戦略
Fil氏は評価フレームワークを3つの領域に整理した。何を評価するか(スコープ)、どう評価するか(手法)、実際にどう適用するか(戦略)だ。
スコープ:コンポーネント、エンドツーエンド、プロファイル
Tractableの現在のアプローチは、コンポーネント単位での厳密なテストを経てからエンドツーエンド評価へ移行する。クライアントや地域によってシステム構成が異なる可能性があるため、評価はプロファイル単位で管理される。あるコンポーネントのアップグレードは、結果に裏付けられた範囲内で特定のプロファイルにのみ適用できる。
ここで見落とされがちな実務上の重要点がある。あるクライアント構成でパフォーマンスを向上させるモデル更新が、別の構成では中立的または逆効果になり得る。評価戦略はこの点を考慮しなければならない。つまり評価スコープとは単一のグローバルテストではなく、それぞれ独立して更新可能なプロファイルの集合なのだ。
手法:データ、量、サンプリング
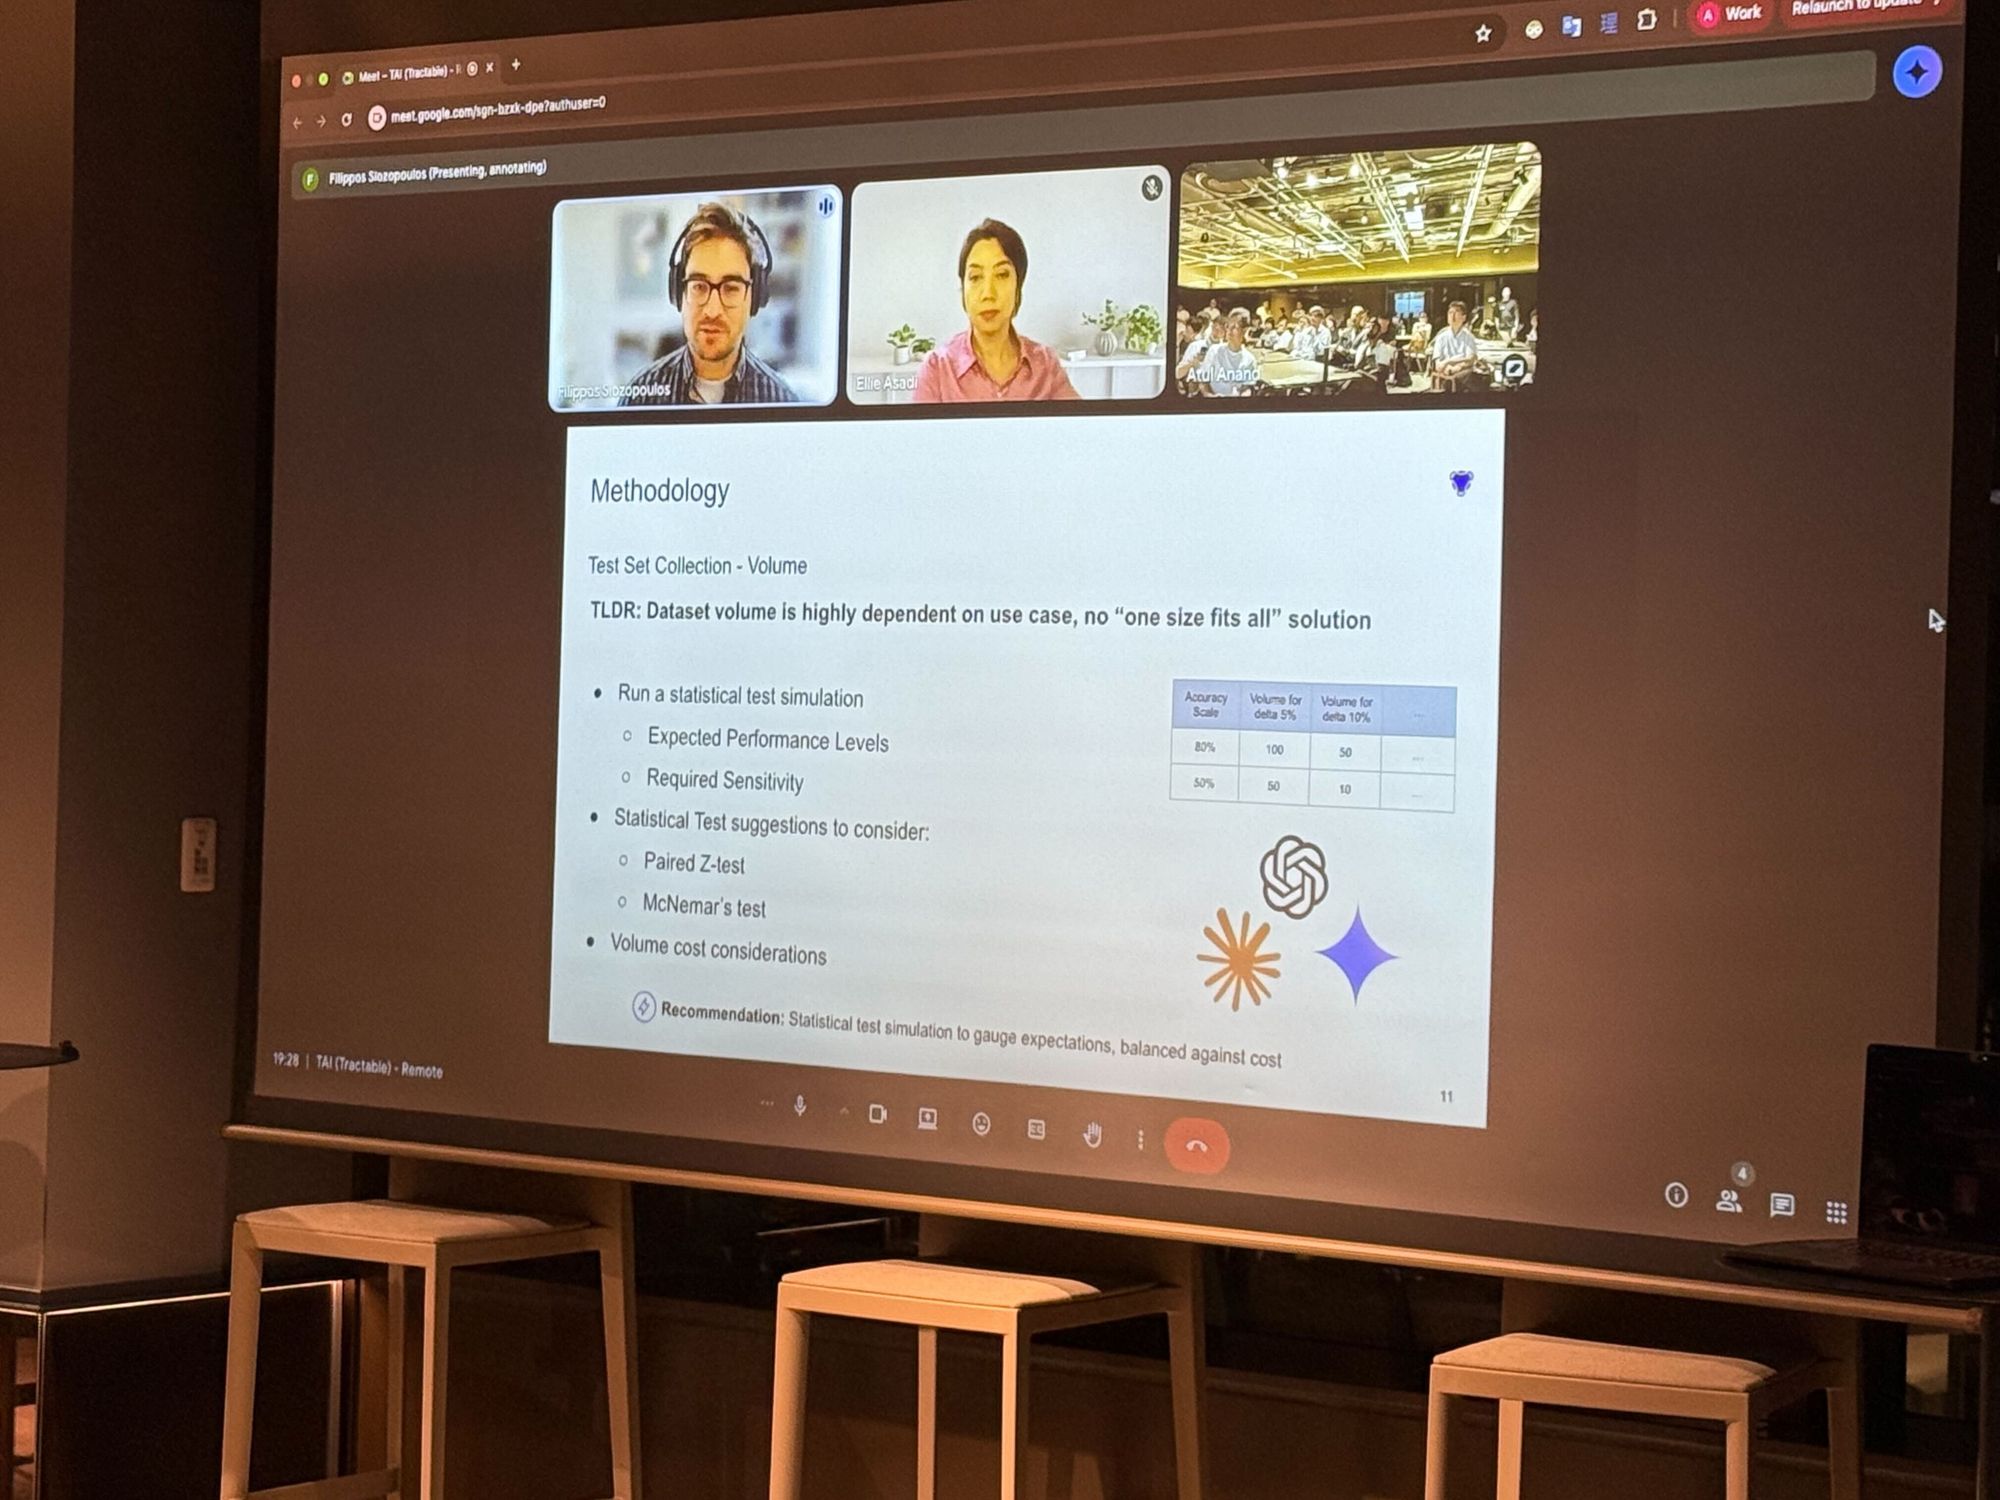
Fil氏の手法に関する提言は、本番AIを評価するチームが必ず直面する3つの問いに答えるものだ。
手動ラベリングデータと本番データ、どちらを使うべきか? Tractableの現在のアプローチは、一般的な評価には本番データを使用し、必要に応じてオンデマンドで手動ラベリングを行う。本番データは大量に自動収集できる反面、ノイズが多く、現行の本番システムの挙動によるバイアスが生じることがある。手動ラベリングデータはクライアント基準との高い整合性や収集内容の細かい制御が可能だが、コストと工数が高い。
どれくらいのデータ量が必要か? Fil氏の推奨は、期待されるパフォーマンス水準と必要な感度を考慮した統計的テストシミュレーションを実施し、推論コストと天秤にかけることだ。考慮すべき統計検定としてPaired Z検定とMcNemar検定が挙げられている。なぜ量が重要かを示す具体例として、スライドには80%対82%(2ポイント改善)は統計的有意ではない可能性がある一方、80%対50%(30ポイント低下)は有意であることが示されている。データセットの量は検出すべき差分の性質によって決まるべきであり、単純にリソースの許す限り増やせばよいというものではない。
どのようにサンプリングするか? Fil氏の推奨は両方実施することだ。本番データからのランダムサンプリングは本番で想定される分布を捉え、実装も単純だが、稀なケースは過小代表になる。ターゲットサンプリングは特定のエラーモードを集中的に評価できるが、実際の本番分布とは乖離する。両者は異なる目的を持ち、堅牢な評価フレームワークには両方が含まれる。
信頼を侵食するエラー(Trust Eroding Errors)
Fil氏の手法で最も特徴的なのが「信頼侵食エラー(Trust Eroding Errors)」という概念だ。集計指標が許容範囲でも、本番で遭遇したとき担当者の信頼を損なう稀なエラーを指す。そのメカニズムは、人間の認知が数値と必ずしも一致しないことにある。担当者が深刻なエラーを1件経験するだけで、精度の集計値では捉えられない形でシステムへの信頼が揺らいでしまう。
Fil氏の推奨は、ドメインの専門家やクライアントと協働しながら、自社製品にとって信頼侵食がどういう意味を持つかを具体的に定義し、そうしたケースへの明示的なチェックを評価に組み込むことだ。これは定量的な計測に先行する定性的なステップだ。信頼侵食エラーは、ドメインにおいてそれが何かを定義しなければ統計的に検出できない。
保険の損傷評価であれば、信頼侵食エラーとは見落とされた構造上の損傷、支払額に影響する誤分類、またはドメイン経験を持つ査定担当者が見て不自然に感じるコスト見積もりかもしれない。具体的なカテゴリは製品によって異なるが、原則は広く通用する。
指標に関する実務的な観点
Fil氏のスライドには指標についての実践的な指摘も含まれる。モデル学習で計測するものが必ずしもクライアントの関心事と一致するとは限らない。Tractableのドメインにおける例として修理工数(労働時間)がターゲット指標として使われており、平均絶対誤差(MAE)が2.45という数値単独では査定担当者には解釈しにくいが、「90%のケースで0.5時間以内の精度で予測できている」という表現であれば意味が伝わる。これはドメインの専門家と協力して導いた、業務上の意味を持つ指標だ。なおこの数値はFil氏のスライド上の例示であり、具体的なデータセットや対象期間等の詳細は資料からは確認できない。
この考え方は規制産業へのAI導入全般に応用できる。モデルの出力に基づいて行動する担当者には、汎用的な精度指標ではなく、自分が解釈できる指標が必要だ。
戦略:オンデマンド評価と自動評価の両立
Fil氏の戦略上の推奨は、オンデマンド評価と自動評価の両方を整備することだ。
オンデマンド評価は導入しやすく、要件が増えるにつれてより高度で専門的な評価に拡張できる柔軟性を持つべきだ。有機的に成長させやすい設計が求められる。スライドでは研究者が自分のワークスペースにインストールして呼び出すコマンドラインツールが例として示されている。
自動評価はCI/CDパイプラインに接続し、コストを抑えるよう慎重に設計した上で、少数の重要な指標に絞り込むべきだ。プルリクエスト発行時にトリガーされる自動パイプラインが例として挙げられている。
2つのアプローチをつなぐ実践的な橋渡しとして、オンデマンド評価のために構築したツールは概ね自動化にも転用できる。別々のシステムを構築するのではなく、オンデマンドのツールを先に整備してから自動化に拡張することで、保守コストを抑えられる。
Fil氏はオンデマンド評価ツールの例としてWeights and Biases(W&B)を示している。評価データセットとAIシステムの推論結果を入力として受け取り、パフォーマンス指標を算出し、結果をW&B Runとしてアップロードしてステークホルダーと共有できるレポートを生成する。スピーカーノートではStreamlitも可搬性の高い選択肢として言及されている。ツール選定の基準として、使いやすさ、共有のしやすさ、評価と推論の分離がキーポイントとして挙げられた。
その他3つの講演の概要
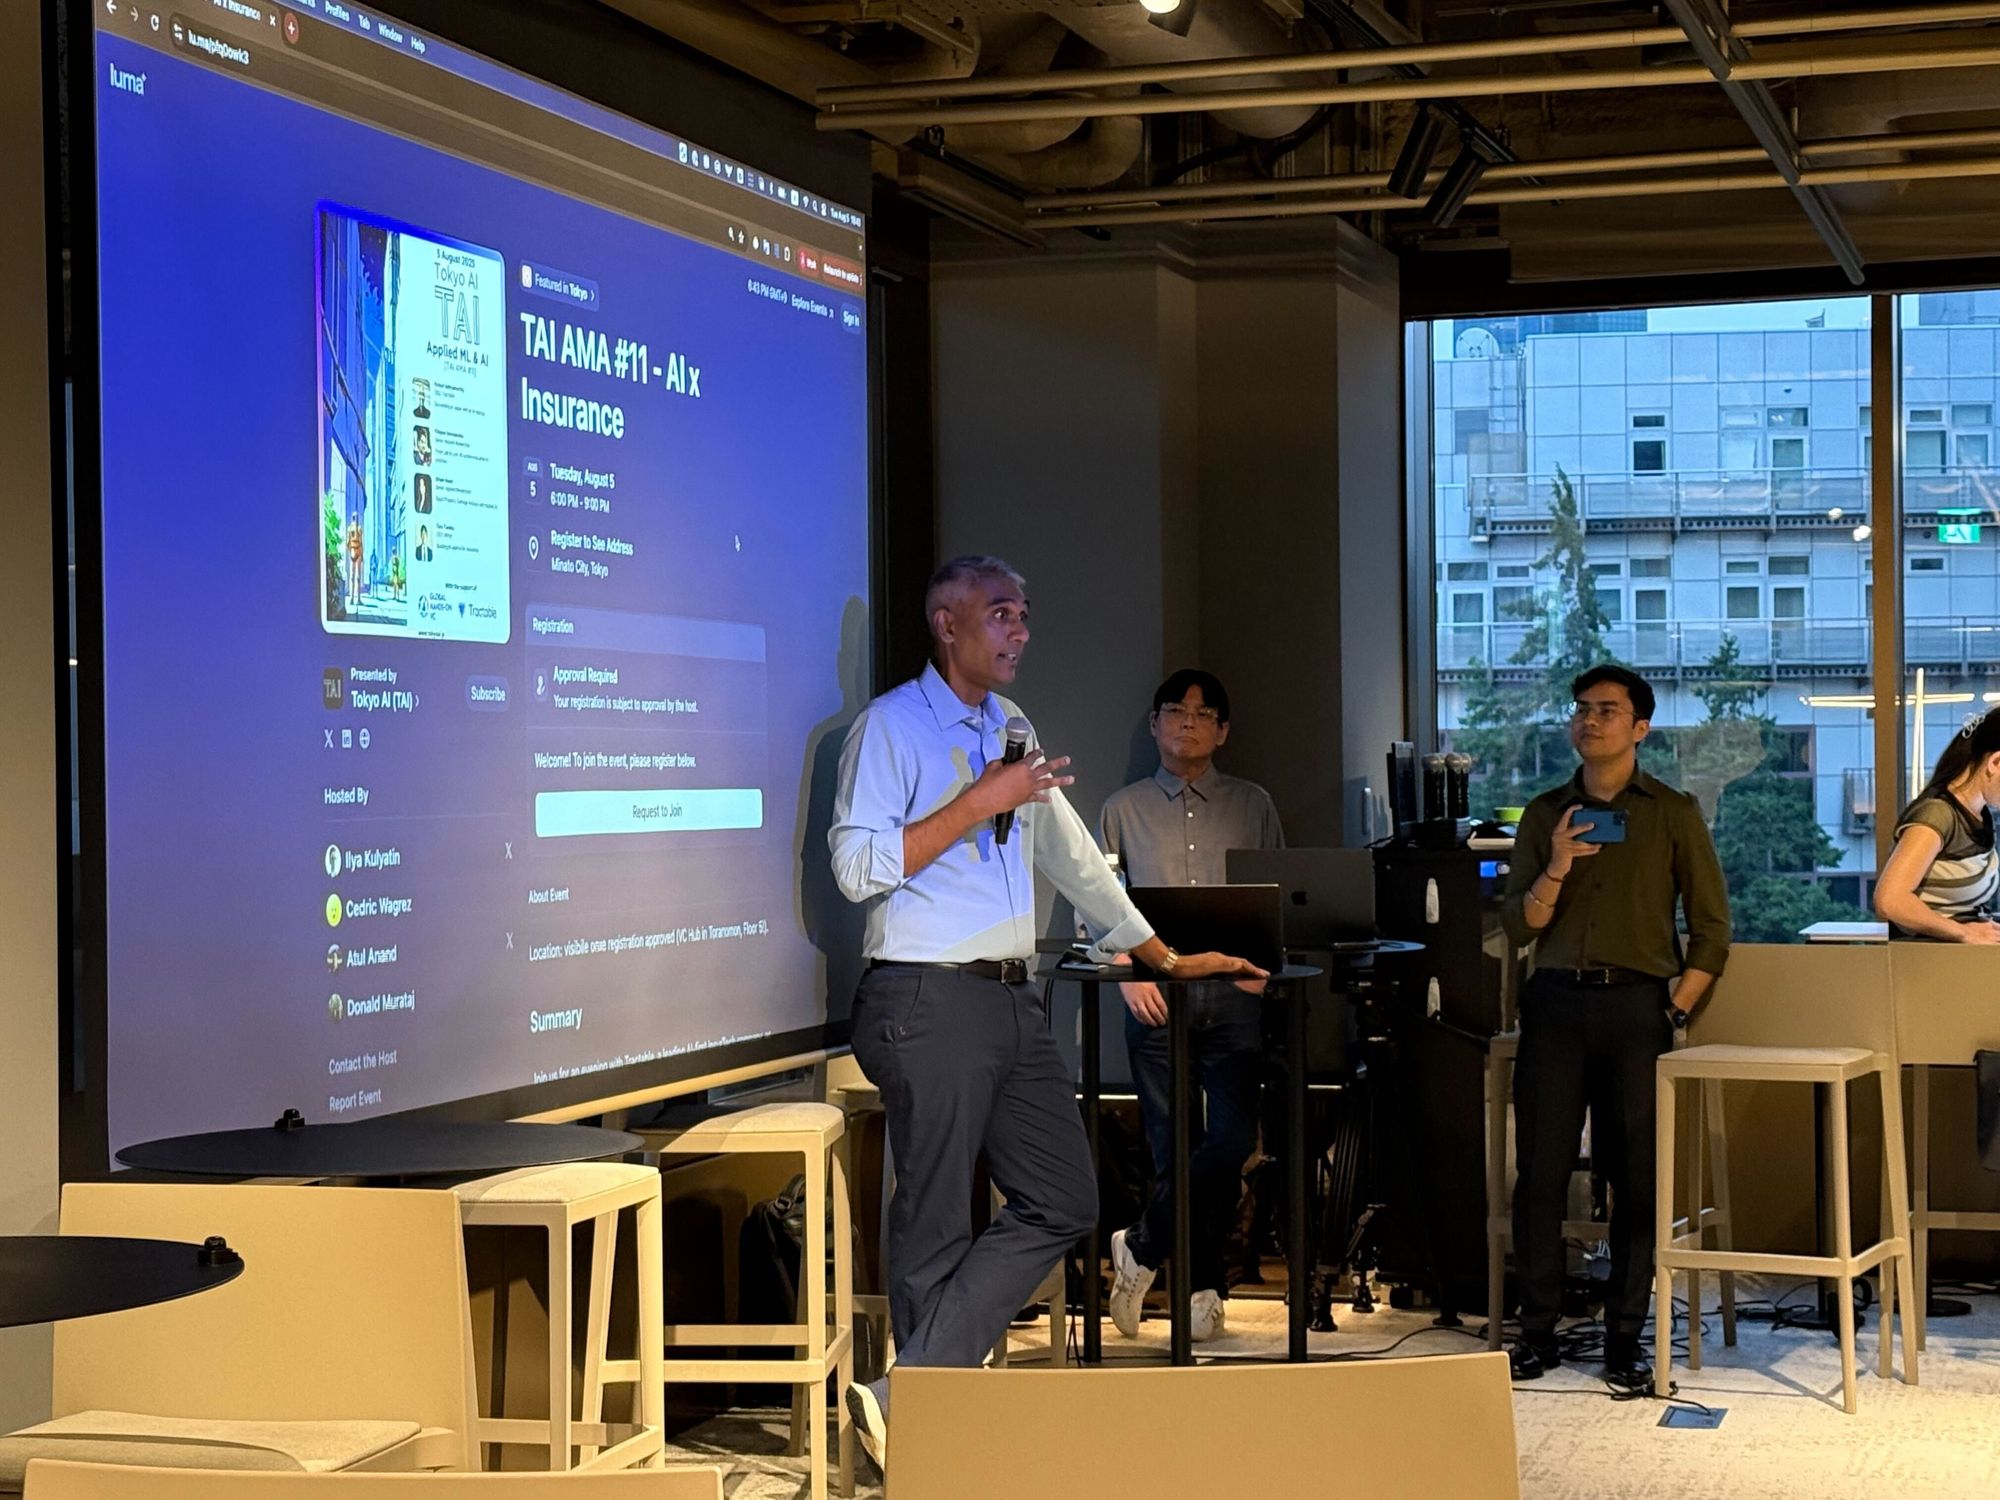
公開プログラムでは、Venkat Sathyamurthy氏の講演はTractableの日本市場への参入と、現地の業務やパートナーシップへの対応を扱うものとして案内された。田中徹氏の講演要旨は、保険・金融サービスにおけるマルチエージェントの活用を紹介している。Elham Asadi氏のセッションには、物件損傷評価のための画像品質の検証、損傷検出、コスト見積もりというテーマが挙げられていた。
これらはイベントの背景を理解するためのプログラム情報である。本稿で具体的に整理した評価手法は、Fil Siozopoulos氏の講演資料に基づいている。
規制産業でAIを構築するチームへの示唆
ここからはFoundry Labsの考察として、保険金請求の確認業務を例に考える。以下は設計を説明するための仮想例であり、実在する顧客への導入実績を示すものではない。
担当者が顧客の写真とAIによる損傷評価を確認する画面では、元の画像、推定内容、例外への対応方法を確認できることが重要になる。画像の品質が足りない場合には追加撮影を依頼し、想定した運用範囲から外れる場合には専門担当者へ回す、といった分岐が考えられる。損傷モデル単体の精度が上がっても、不要な差し戻しが増えたり、判断に必要な情報が見えなくなったりすれば、業務全体が改善したとは言えない。
Fil氏のコンポーネント評価とエンドツーエンド評価の区別は、この問題を整理する手がかりになる。変更したモデルを単体で確認した後、顧客や地域の構成ごとに、担当者の確認までを含む流れへの影響を調べる。通常の挙動は本番データからの代表的なサンプルで確認し、特に信頼を損なう誤りは対象を絞ったケースで評価する。例外の定義や業務上の指標は、実際に出力を使う専門家と決める必要がある。
プロトタイプの段階から、入力、出力、人による判断を追える状態を作り、更新前後を比較できる評価データを残しておく。別の業務や顧客へ広げる際には、その構成での結果を確かめ、更新を受け入れる責任者を明確にする。集計スコアをそのまま導入判断に置き換えないための、具体的な設計課題だ。
Foundry LabsのエンタープライズAIサービスは、本番AIシステムの設計と実装を支援する。今回の講演とつながるのは、プロトタイプの後に必要になるデータ収集、評価、例外処理、そして判断する人の役割を、一つの業務として組み立てる仕事である。
Tokyo AIとFoundry Labsについて
Tokyo AI(TAI)は、エンジニアや研究者をはじめとするAI実践者が技術を共有するコミュニティだ。Foundry Labsは日本でエンタープライズAIエンジニアリングを提供している。TAIについてはコミュニティページもご覧いただきたい。
参考リンク
登壇資料について
以下の登壇資料をご希望の方は、お問い合わせフォームよりイベント名と登壇者名を添えてご連絡ください。
- From Lab to Live: AI System Evaluation in Practice(Filippos Siozopoulos、Tractable)
登壇者プロフィール
肩書きと経歴はイベントの公開プログラムに基づいています。
Venkat Sathyamurthy
公開プログラムでは、Venkat Sathyamurthy氏はTractableのCEOとして紹介されている。経歴には、Microsoft、Adobe、DocuSignなどでの25年超の企業向けテクノロジー分野の経験が記されている。講演はTractableの日本市場への参入と、現地の業務やパートナーシップへの対応を扱うものとして案内された。
Toru Tanaka
田中徹氏は、AIと金融テクノロジーを組み合わせたソリューションを開発するMILIZE, Inc.のCEOとして紹介されている。イベントの経歴には、フィンテックや食品サービス分野での起業経験が記載されている。講演要旨では、保険・金融業務でのLLM駆動型マルチエージェントシステムをテーマとしていた。
Filippos Siozopoulos
Filippos(Fil)Siozopoulos氏は、NLP・深層学習・コンピュータビジョンに取り組むTractableのSenior Applied Researcherとして紹介されている。公開経歴にはSamsung Research UKでの勤務、UCLでの機械学習修士号、アテネ国立工科大学での電気・コンピュータ工学修士号が記載されている。講演資料では、本番AIシステムの評価フレームワークを説明している。
Elham Asadi
Elham(Ellie)Asadi氏は、TractableのPropertyチームに所属するSenior Applied Scientistとして紹介されている。公開経歴には、HORIBA MIRAでの自動運転向けAI開発を含む15年超の機械学習・コンピュータビジョン経験、ブリストル大学での航空宇宙工学博士号、ケンブリッジ大学でのポスドク研究が記載されている。講演は物件損傷評価のAIパイプラインを扱うものとして案内された。
記事一覧