Foundry Labs / コミュニティから
日本語LLM:コーパスと評価から設計を始める
目次
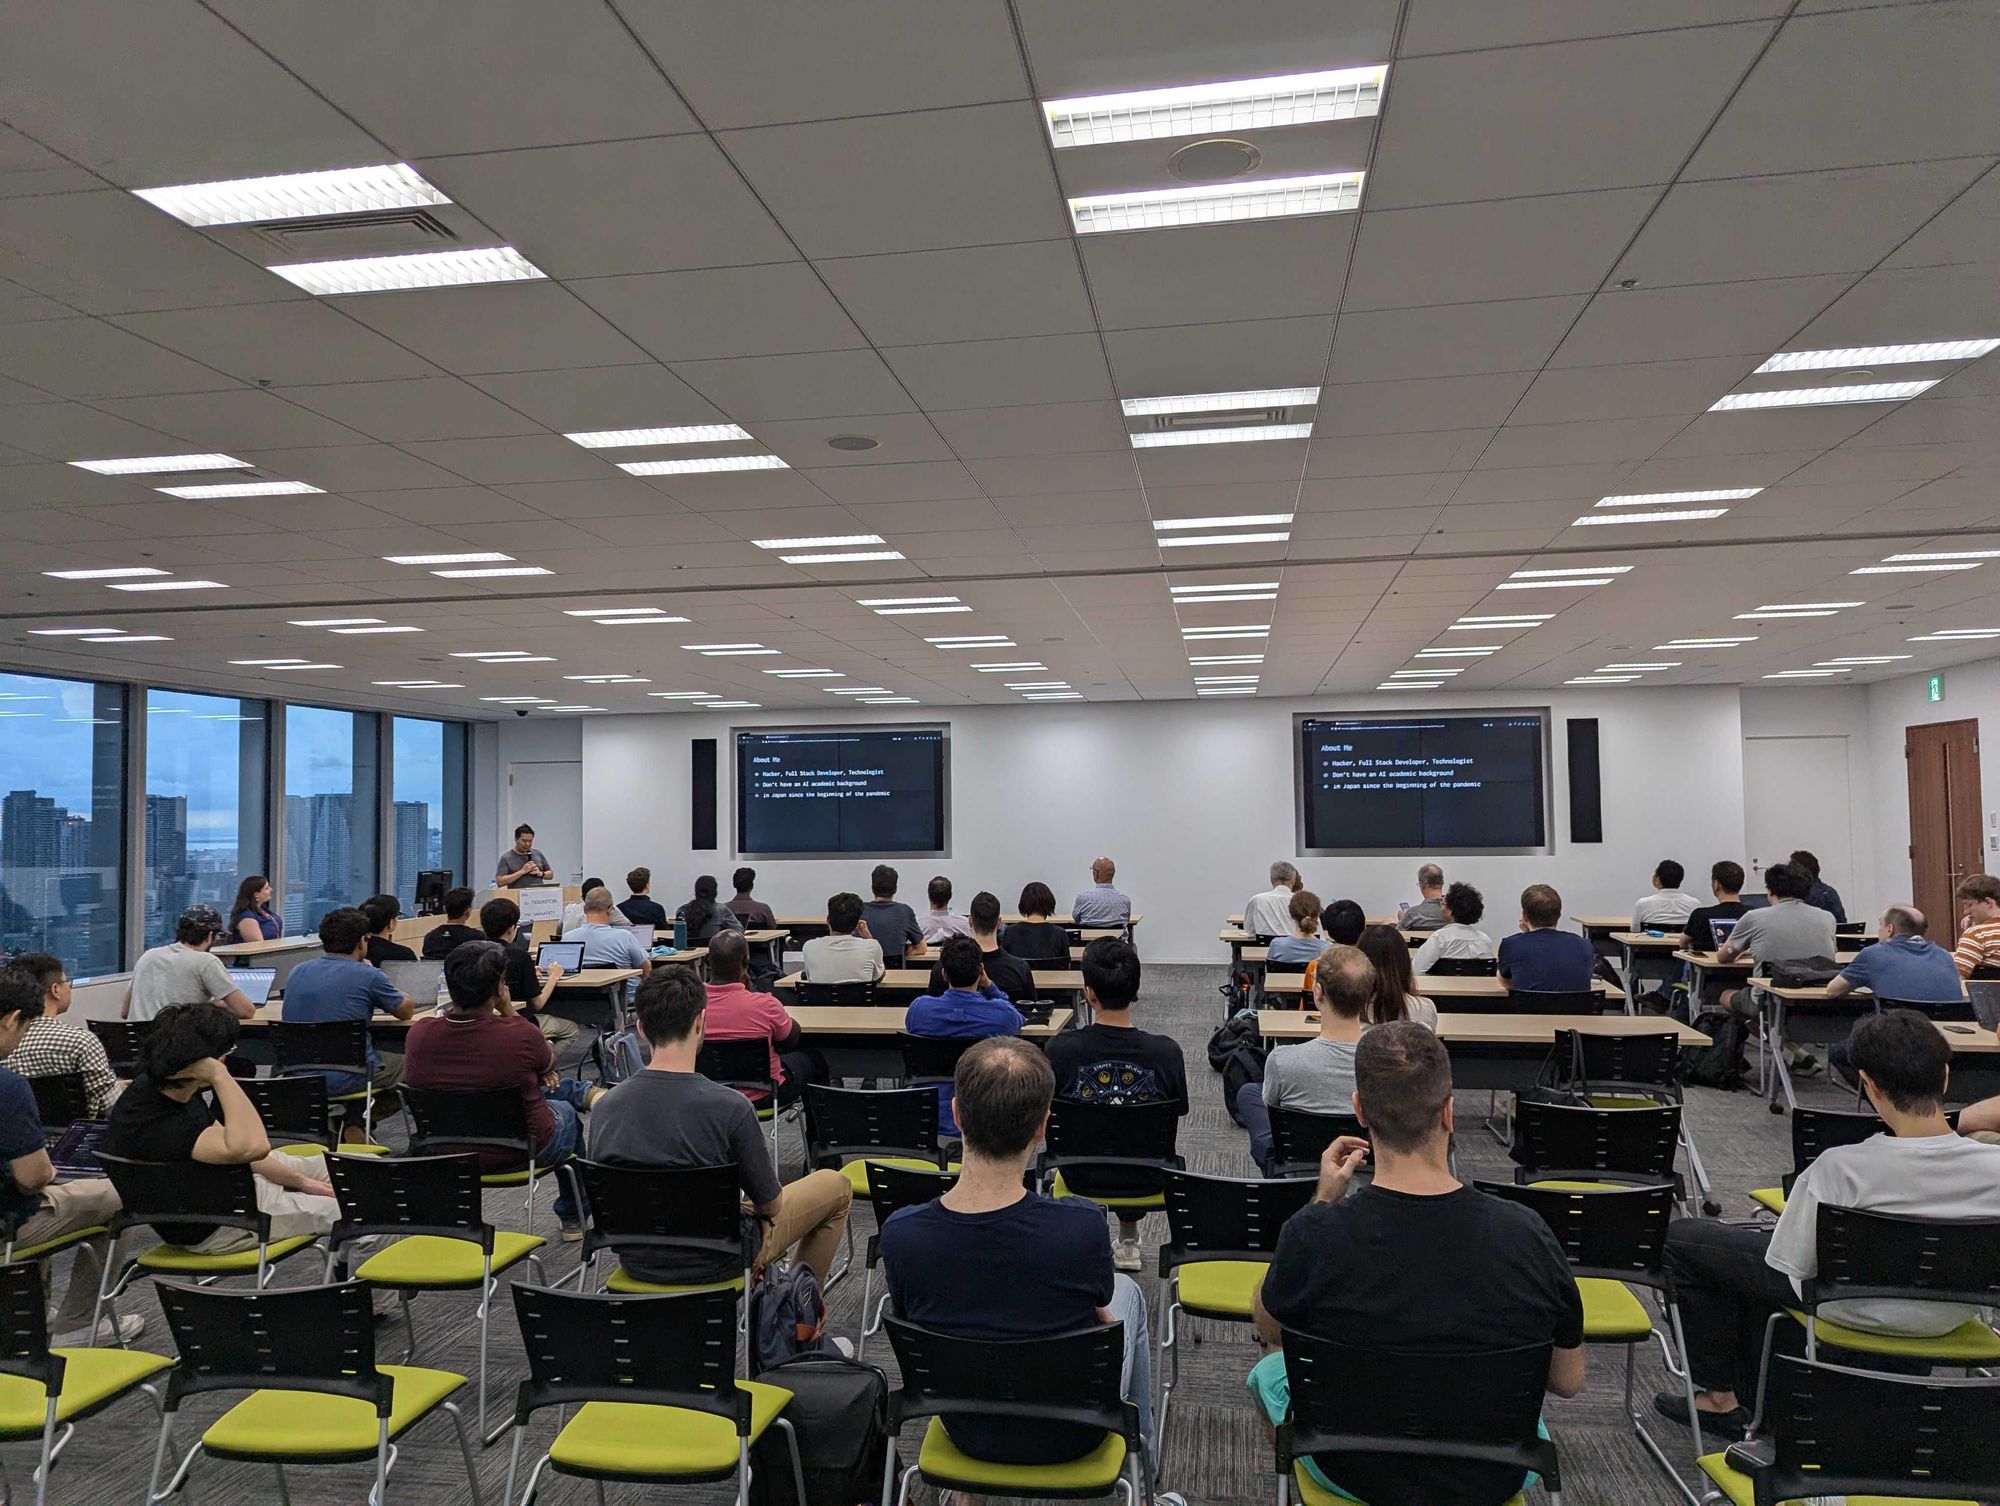
日本語を使う業務のAIは、英語中心の一般的な性能だけでは評価できません。Tokyo AIの2024年のNLPイベントでは、日本語モデルを支えるコーパス、トークナイザー、実際の日本語利用を反映する評価が重要な論点になりました。
コーパスの選び方は製品の振る舞いになる
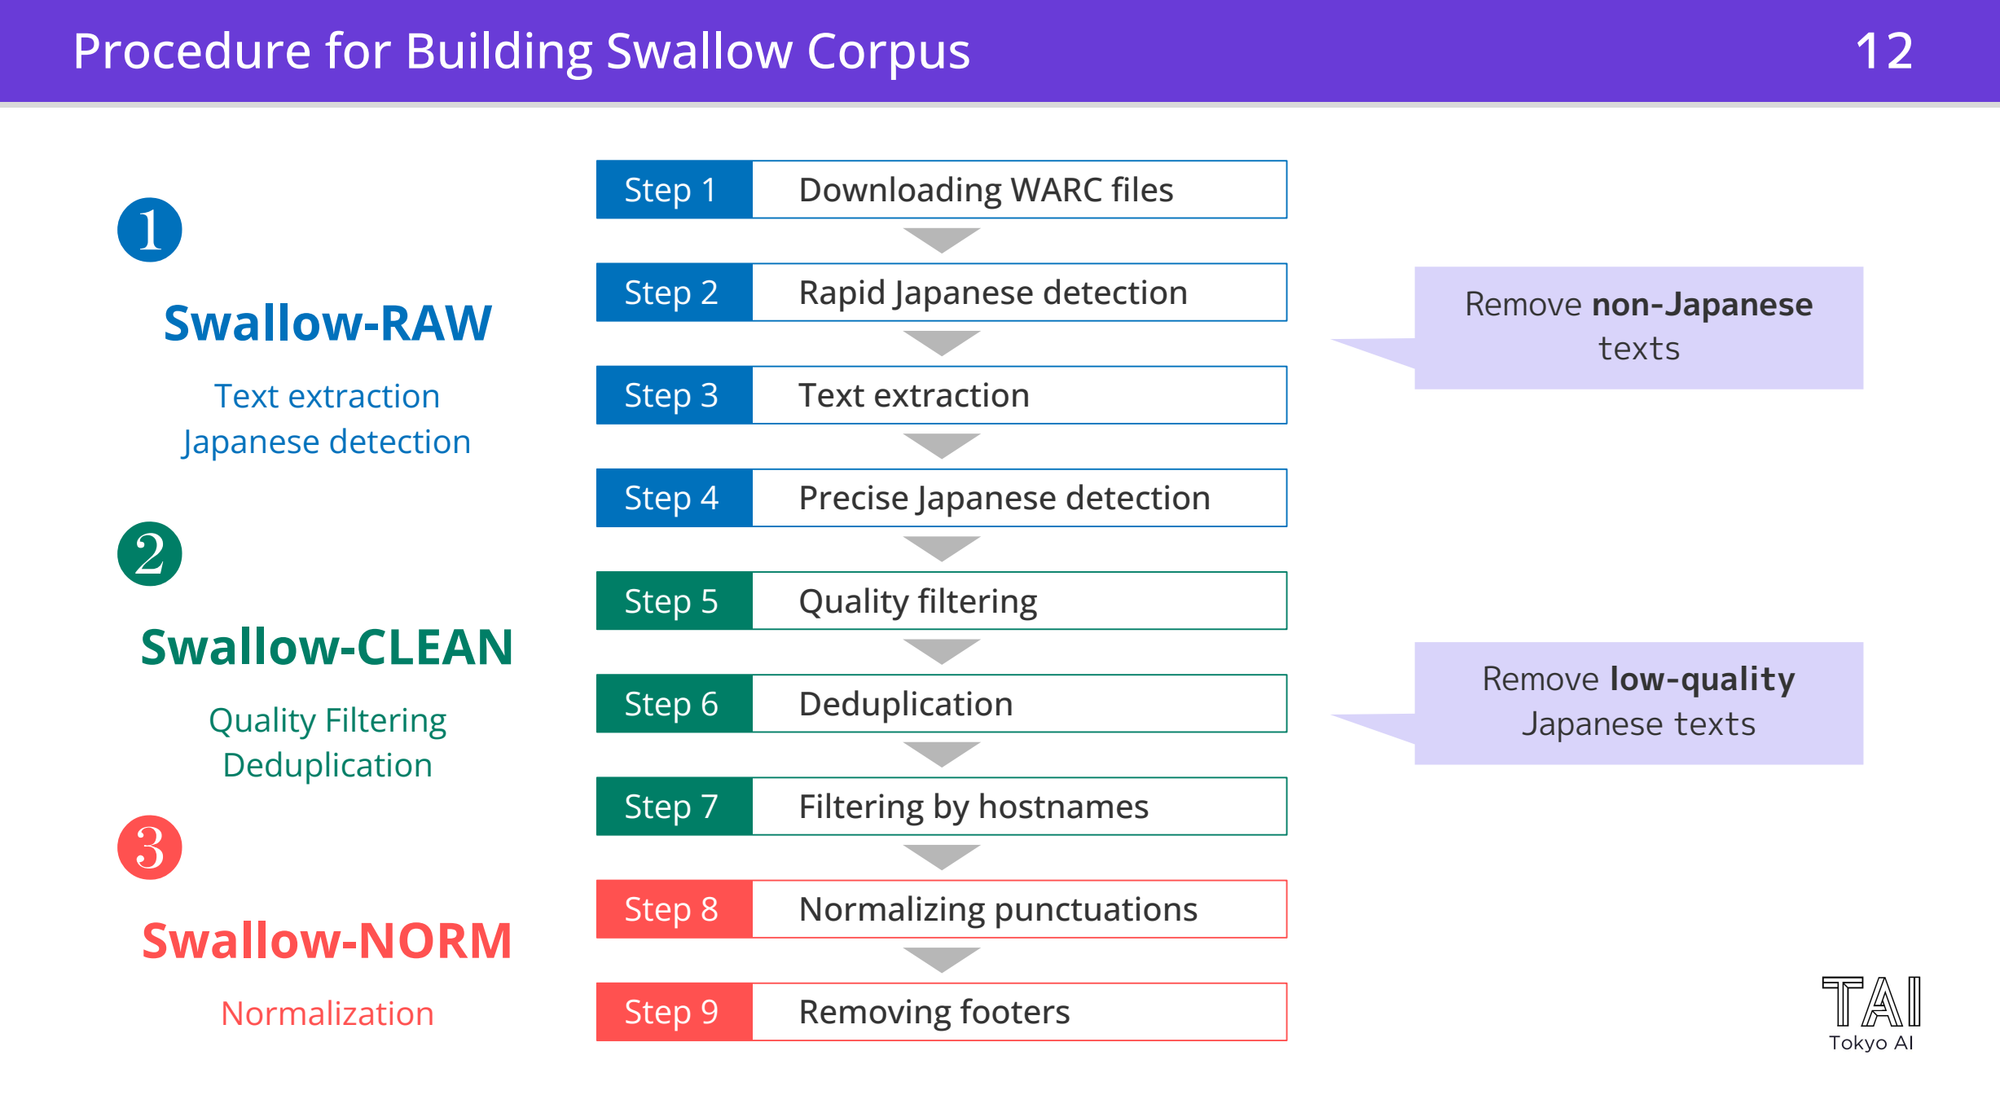
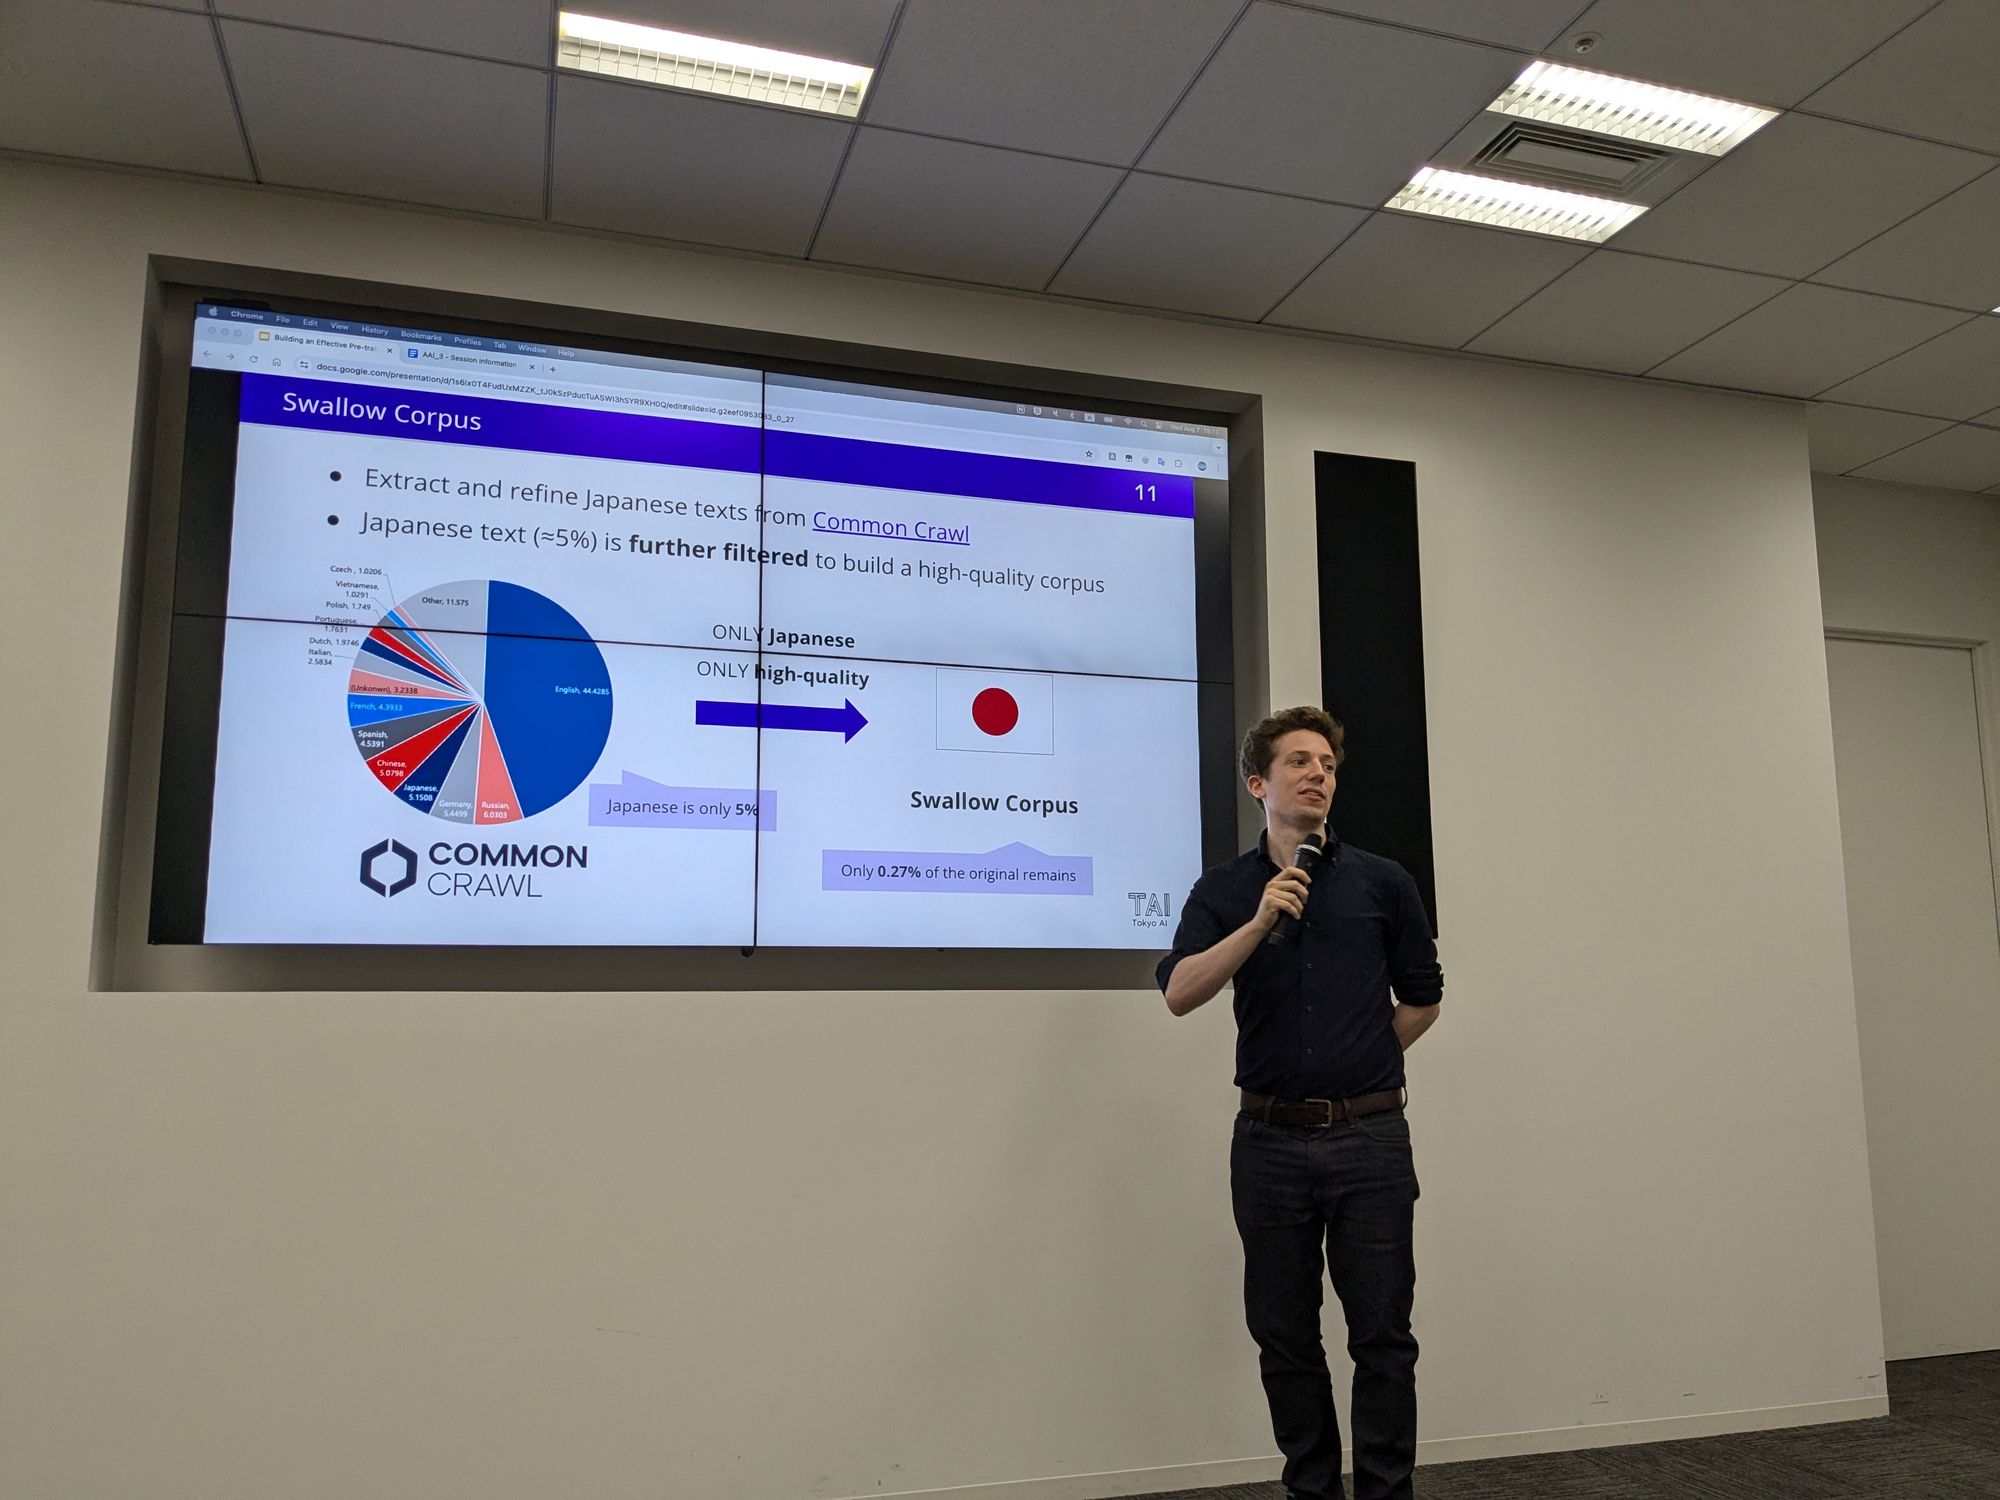
Kakeru Hattori氏は、Swallowプロジェクトで日本語Webコーパスを構築する取り組みを紹介しました。大量の文章を集めるだけでは、良い学習データにはなりません。重複、品質の低いページ、分野の偏り、利用条件が学習結果を左右します。出典と除外の判断を残しておけば、ある文書は得意で別の文書は苦手という差を説明し、後から学習をやり直すこともできます。
Leonard Lin氏のShisaに関する発表では、トークナイザーの拡張、追加事前学習、合成データ、ファインチューニングが取り上げられました。これらは同じ問題を解く別名ではありません。トークナイザーは日本語の表現単位、コーパスはモデルが見る内容、ファインチューニングは求める振る舞いに関わります。一つを変えた結果、別の用途で品質が下がる可能性もあります。公開された学習成果物は検証を助けますが、導入側は自社の業務で試す必要があります。
実際に使われる日本語で試す
敬語、省略された製品名、英語が混ざる問い合わせを読む支援AIを考えます。試験には、曖昧な依頼や回答を保留すべきケースも含めます。担当者は、顧客の意図を保てたか、正しい記録を参照したか、サービスにふさわしい文体かを確認します。一般的なベンチマークの点数だけでは、その業務を安全に回せるかは分かりません。
本番導入では、学習データの問題と運用上の問題を分けます。処理してよい日本語データを定め、業務固有の評価ケースを作り、モデルや検索先が変われば再評価します。日本語の品質はモデル名ではなく、全体の工程で作るものです。
Tokyo AIは、Foundry Labsが運営する日本の開発者、研究者、ビジネスリーダーのコミュニティです。イベントページもご覧ください。
登壇者の講演資料は、ご希望に応じてご案内できます。お問い合わせフォームからイベント名と登壇者名をお知らせください。
登壇者
- Leonard Lin:Shisa.AI創業者・CTO。
- Kakeru Hattori:日本語LLM「Swallow」の研究者。