Foundry Labs / コミュニティから
継続稼働するAIエージェントのLLMOps:実行記録を業務改善につなぐ
目次
一問に答えて終わるチャットと、仕事を継続するエージェントでは、運用上の問題が異なります。後者は状態を引き継ぎ、新しい出来事に反応し、最初の会話から時間がたっても業務システムへ影響します。LLMOpsでは、モデル評価を実際の仕事の流れにつなぐ必要があります。
2025年10月22日にMoney Forward、Tokyo AI、Databricksが開催した「The Agent Revolution: Building Tomorrow’s AI」では、コンテキスト設計、評価と管理、継続的に業務へ参加するエージェントが扱われました。
コンテキストを、管理すべき運用資源として扱う
Darren Loke氏は、AgentForwardの開発を通じて、次の処理に必要な情報を適切に渡すコンテキスト設計を重視しています。仕事が続くたびに文章を蓄積するだけでは、必要な情報を扱いやすく保てません。
講演では短期的な文脈と長期的な記憶を分け、役割を絞ったエージェントも紹介しています。例えば文書を検証する機能は、業務全体の長い会話を引き継がなくても、明確な入力と基準で確認できる場合があります。
問題が起きたときには、どの指示、取得情報、記憶を参照していたかを再現できることが重要です。情報不足なのか、推論の誤りなのか、ツールの応答が不適切なのかを分けて調べられます。
本番の実行記録を、次の評価へ戻す
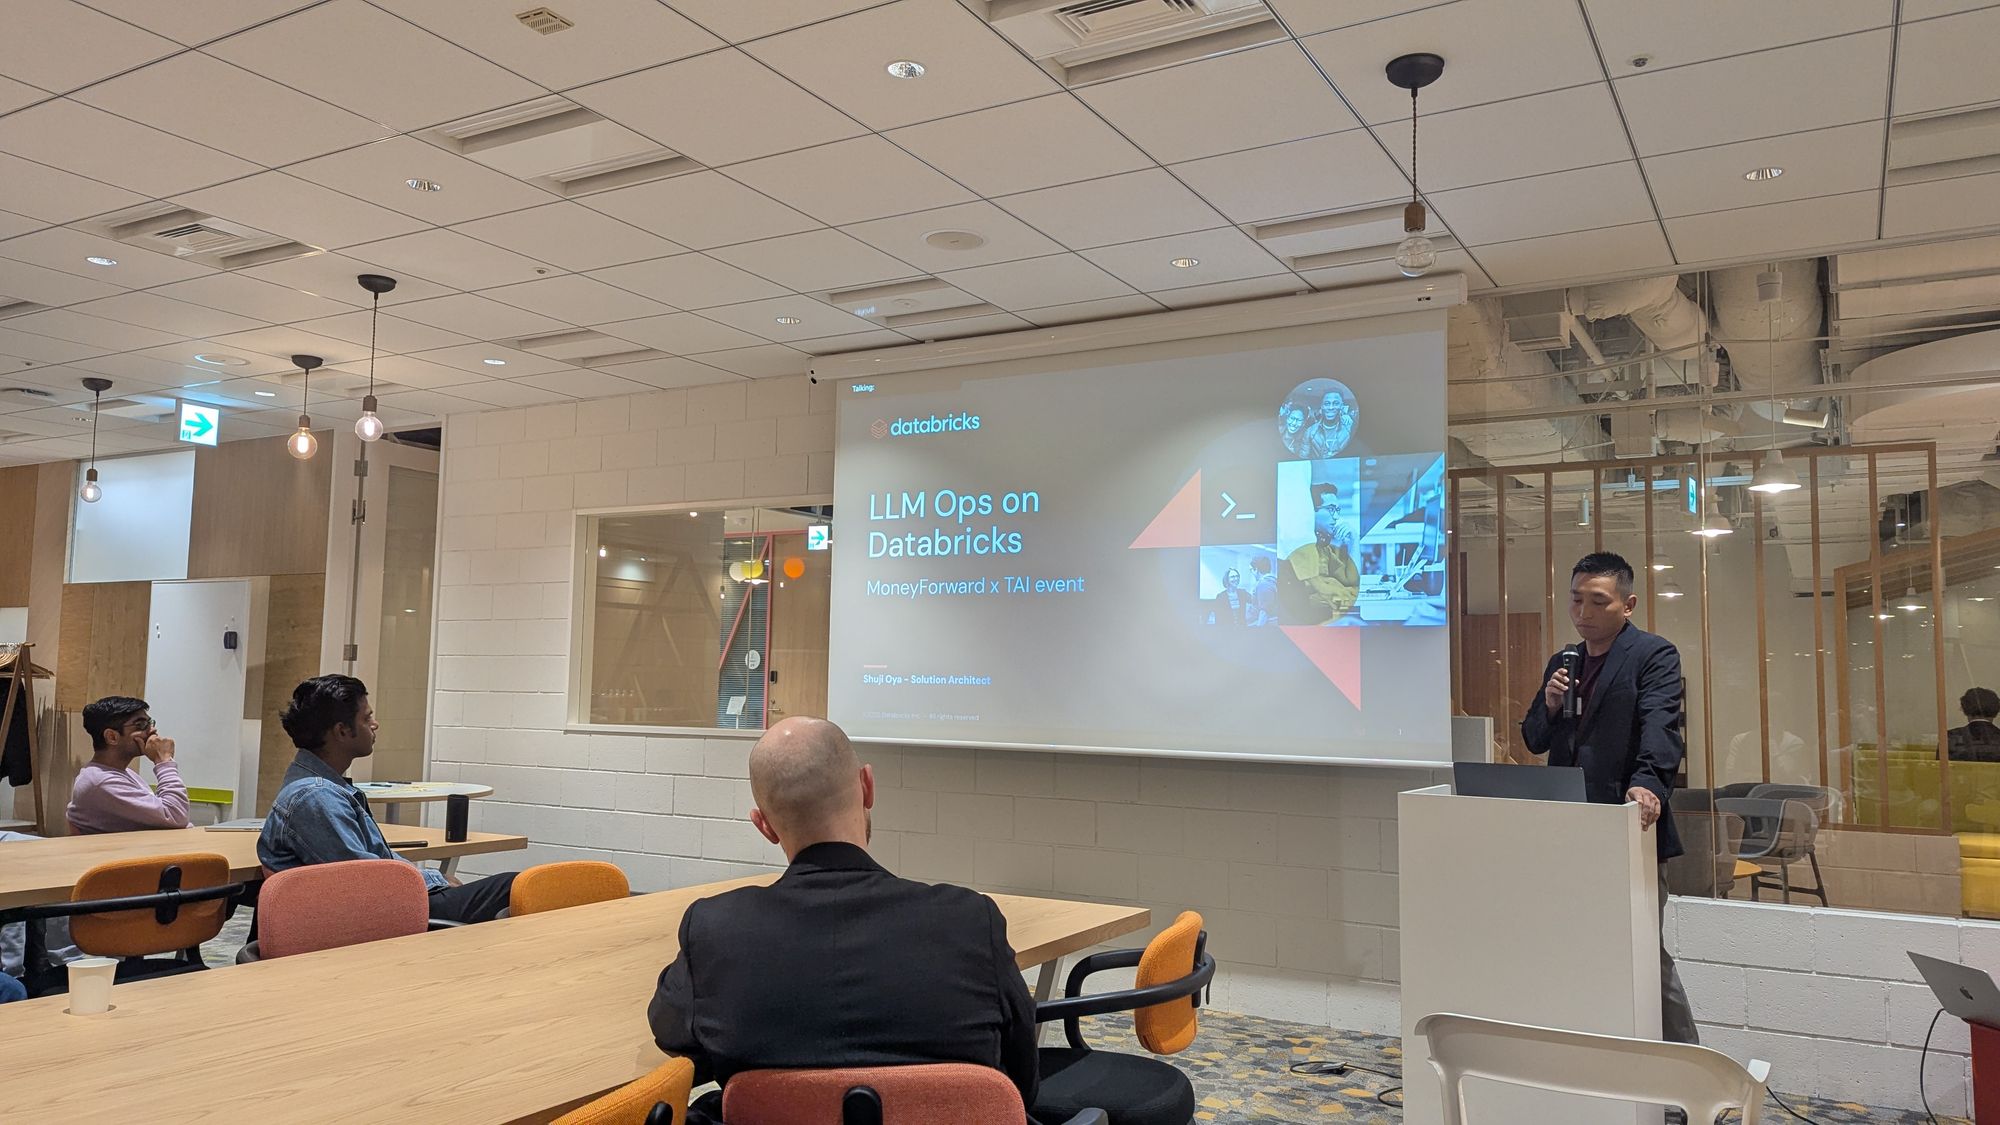
DatabricksのSolutions Architect、Shuji Oya氏は、開発時の評価、本番の実行記録、専門家からのフィードバックをつなぐ改善ループを示しています。テストして配備し、動作を観測し、その結果を評価用の事例へ戻す流れです。
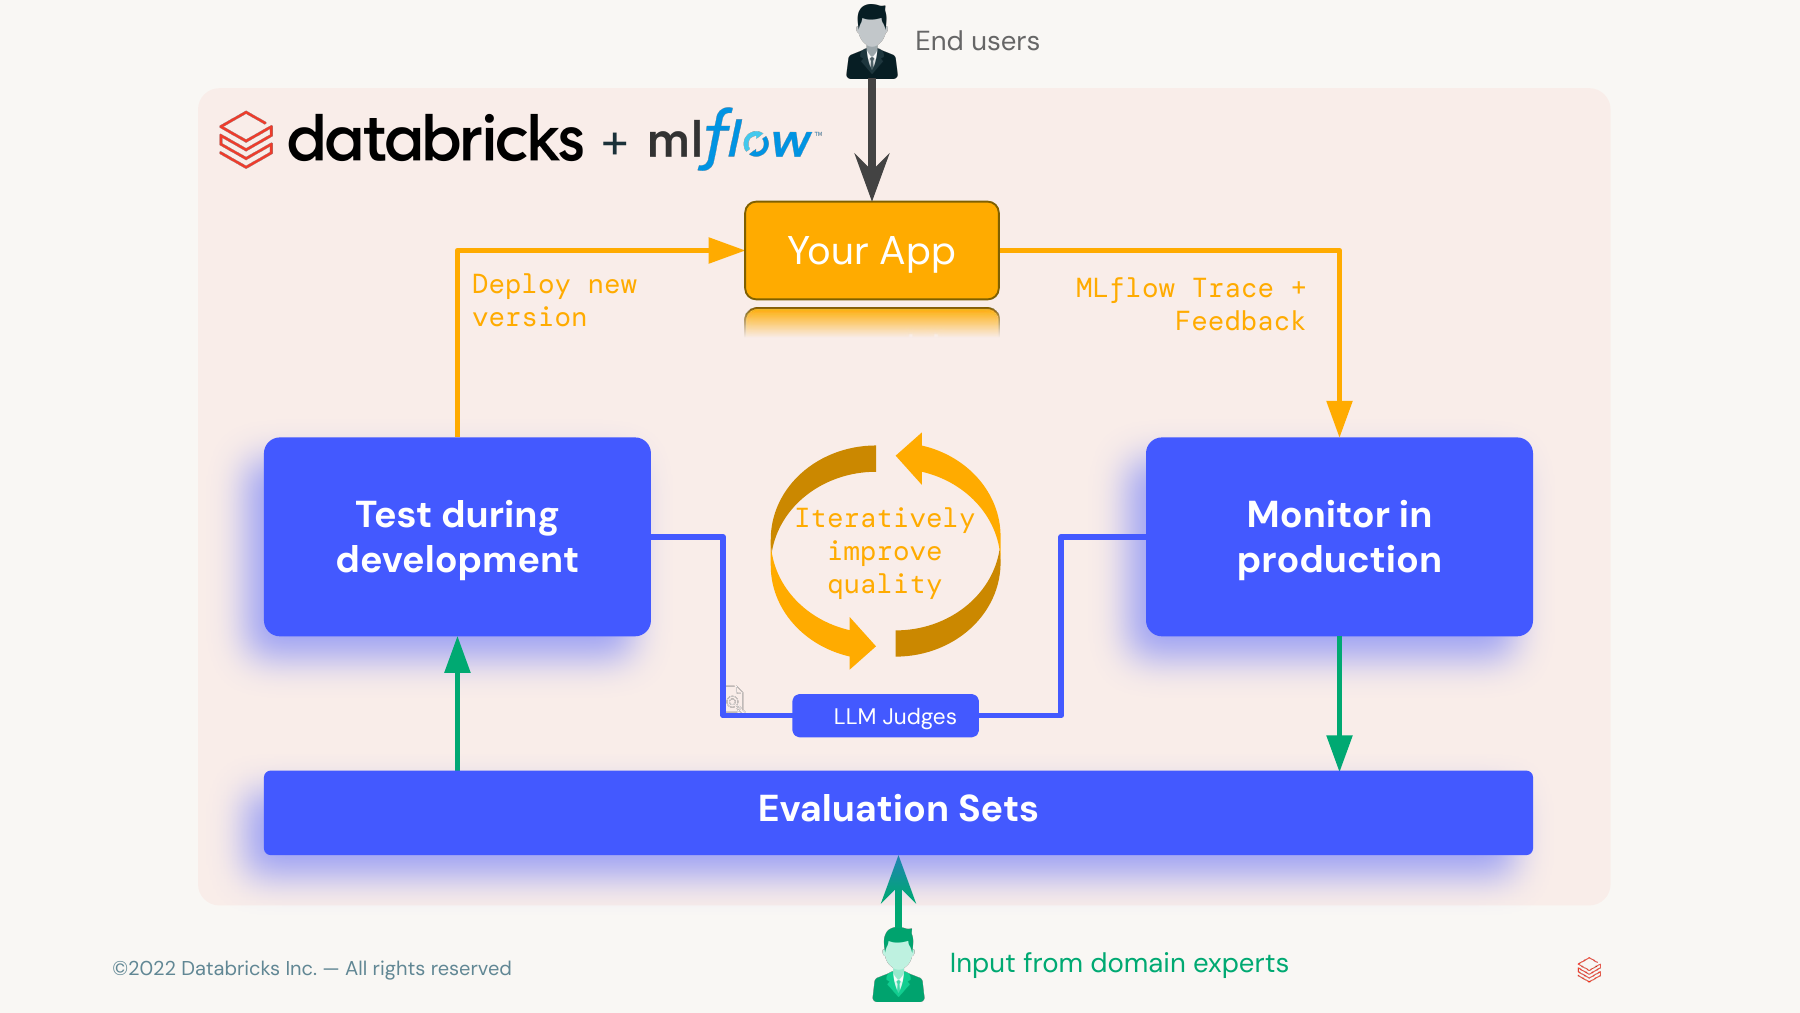
実行記録の価値は、単に履歴が残ることではありません。失敗を再現し、次の変更でも同じ問題が起きないか試せる形にすることにあります。担当者による訂正も、期待する結果と必要な文脈を伴えば、評価事例になります。
Oya氏はアクセス、利用量、制限などの管理も扱います。出力が正しいことと、要求が許可されたものであることは別の確認事項です。両者をつなぎながら、それぞれの責任を区別します。実装の詳細は、MLflowの公式トレーシング資料で確認できます。
会話の保存だけでは、仕事は続かない
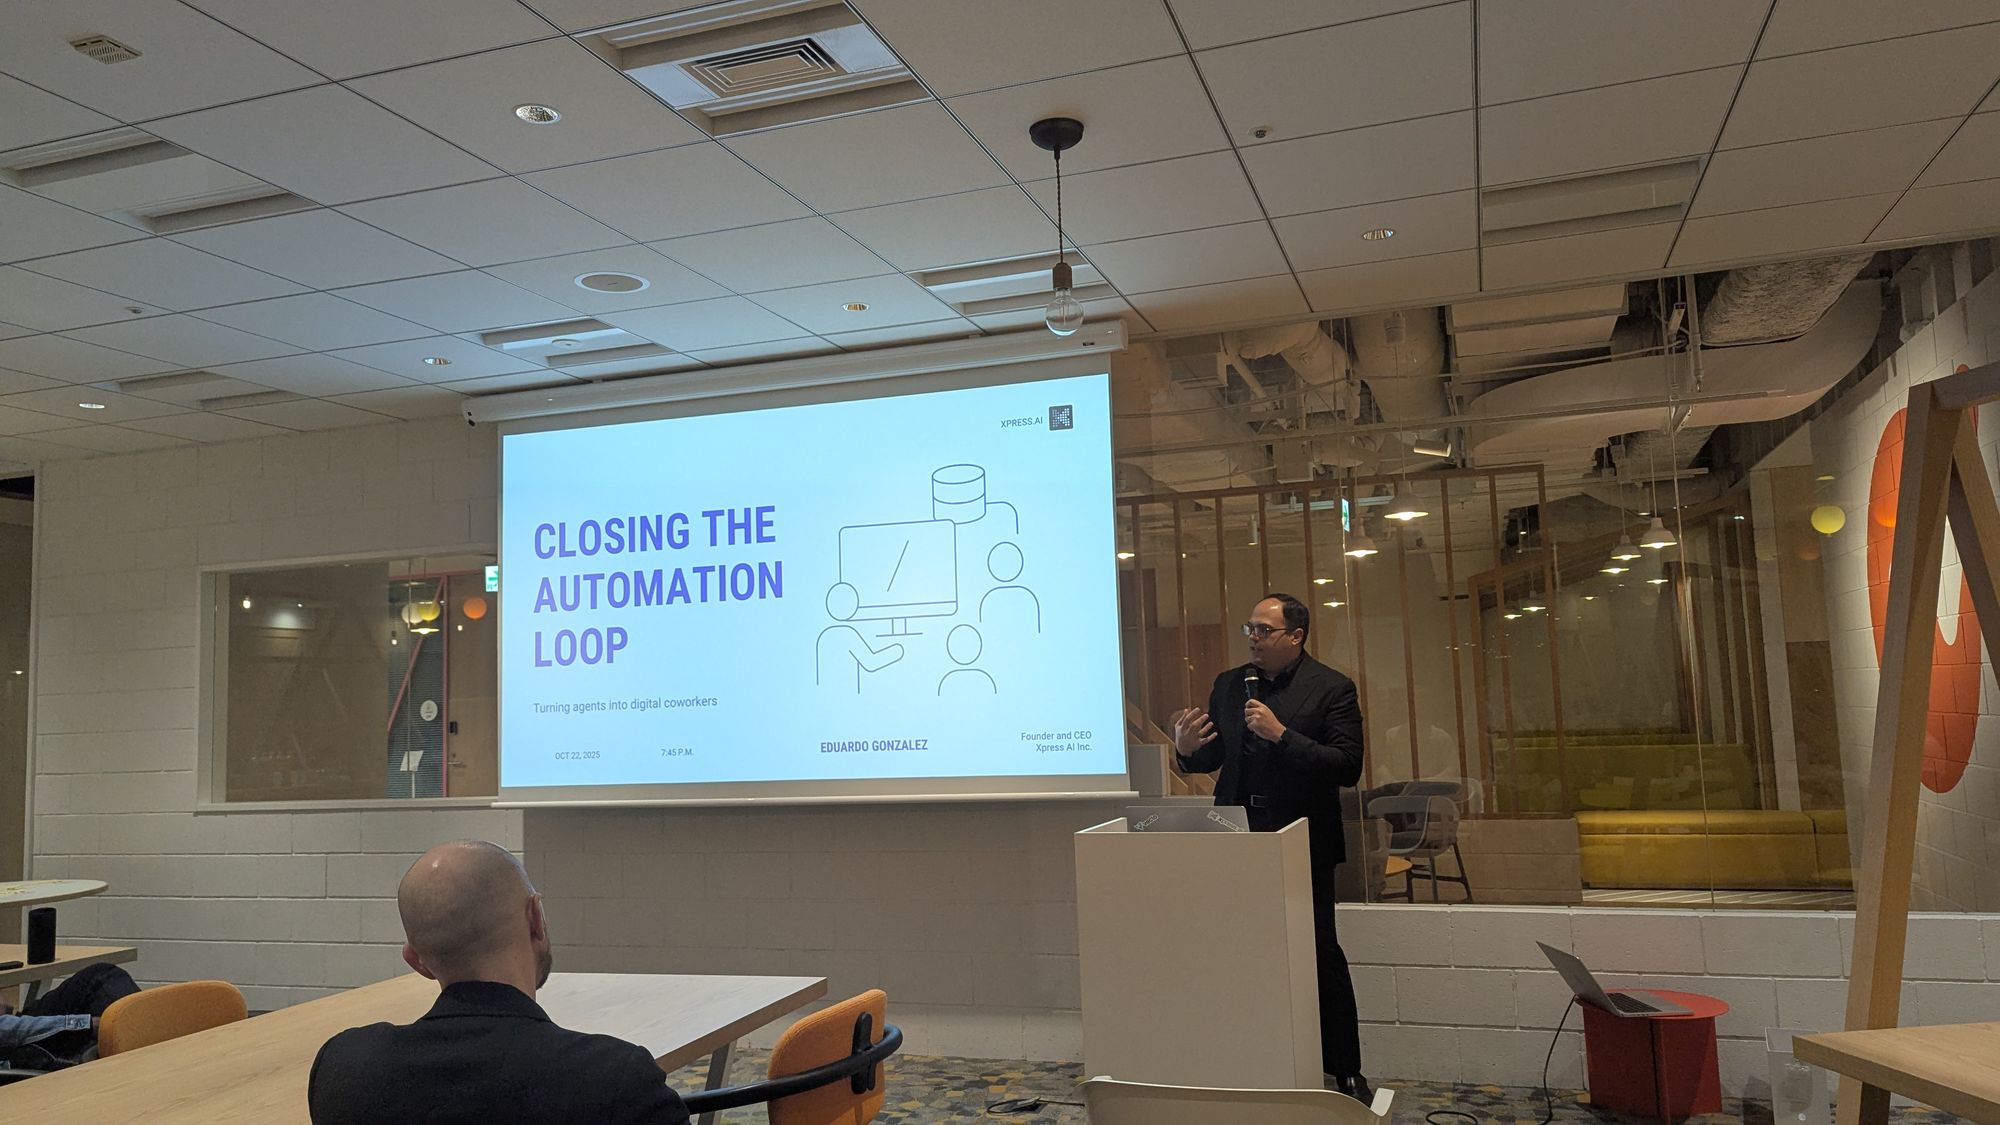
Xpress AIの共同創業者兼CEO、Eduardo Gonzalez氏は、人が次のメッセージを送るまで待つだけでなく、出来事に反応して仕事を進めるエージェントを扱います。階層的なコンテキストや、情報取得から業務アプリへつなぐ注文処理が題材です。
必要なのは会話履歴だけではありません。未完了の仕事、完了した操作、次の処理を始める条件を表す状態が必要です。常時接続していても、その状態が曖昧なら、仕事を確実に進められるとは限りません。
承認待ち、情報待ち、接続障害からの復旧中では、必要な対応が違います。担当者にも、その違いが分かるようにします。
Foundryの視点:購買申請の一連の流れを運用する
承認済みの需要情報から購買申請を用意するエージェントを、仮の例として考えます。PoCはデータを取得してフォームを埋められれば成立します。継続運用では、翌日に届く承認、仕入先情報の変更、タイムアウトしたが実行済みかもしれない申請も扱います。
こうした条件を、業務の状態として明示します。申請には担当者、根拠データ、承認状況、外部操作の記録を持たせます。新しい会話を始めても、取引の状態が消えない構成です。
重複申請が起きたなら、同じ通知を二度処理したのか、ツールの応答を誤解したのか、再試行の確認が足りなかったのかを記録から調べます。対策を具体的な再発防止テストへ変えれば、「注意する」という指示だけに頼らずに済みます。
最初は下書きと確認待ちの管理までを自動化し、申請権限は人に残せます。未解決の仕事、不正な状態遷移、重複操作、訂正時間などを測り、モデル品質や費用と合わせて判断します。
次の版も同じ基準で評価します。モデル変更で解釈が改善しても、ツールの使い方が変わる可能性があります。Foundry Labsの本番AIシステム開発につながるのは、実運用から得た学びを、次の変更で確かめられる状態にすることです。
出典・関連情報
本記事は、TAI AMA #13 - LLM Ops on Databricksのイベント案内と上記の講演をもとに構成しています。Tokyo AI(TAI)は研究者、エンジニア、企業をつなぐコミュニティです。Foundry Labsのコミュニティ活動もご覧ください。
Darren Loke、Shuji Oya、Eduardo Gonzalezの登壇資料をご希望の方は、お問い合わせフォームより、イベント名と登壇者名を添えてご連絡ください。
登壇者プロフィール
Darren Loke。Money ForwardのTechnical Lead/Solution Architect。AgentForwardをテーマに登壇。 LinkedIn
Shuji Oya。DatabricksのSolutions Architect。エージェントとLLMアプリケーションの運用をテーマに登壇。 LinkedIn
Eduardo Gonzalez。Xpress AI共同創業者・CEO。継続して動く自律エージェントに取り組む。 LinkedIn
記事一覧