Foundry Labs / コミュニティから
オフライン強化学習:過去のデータで分からないことを見極める
目次
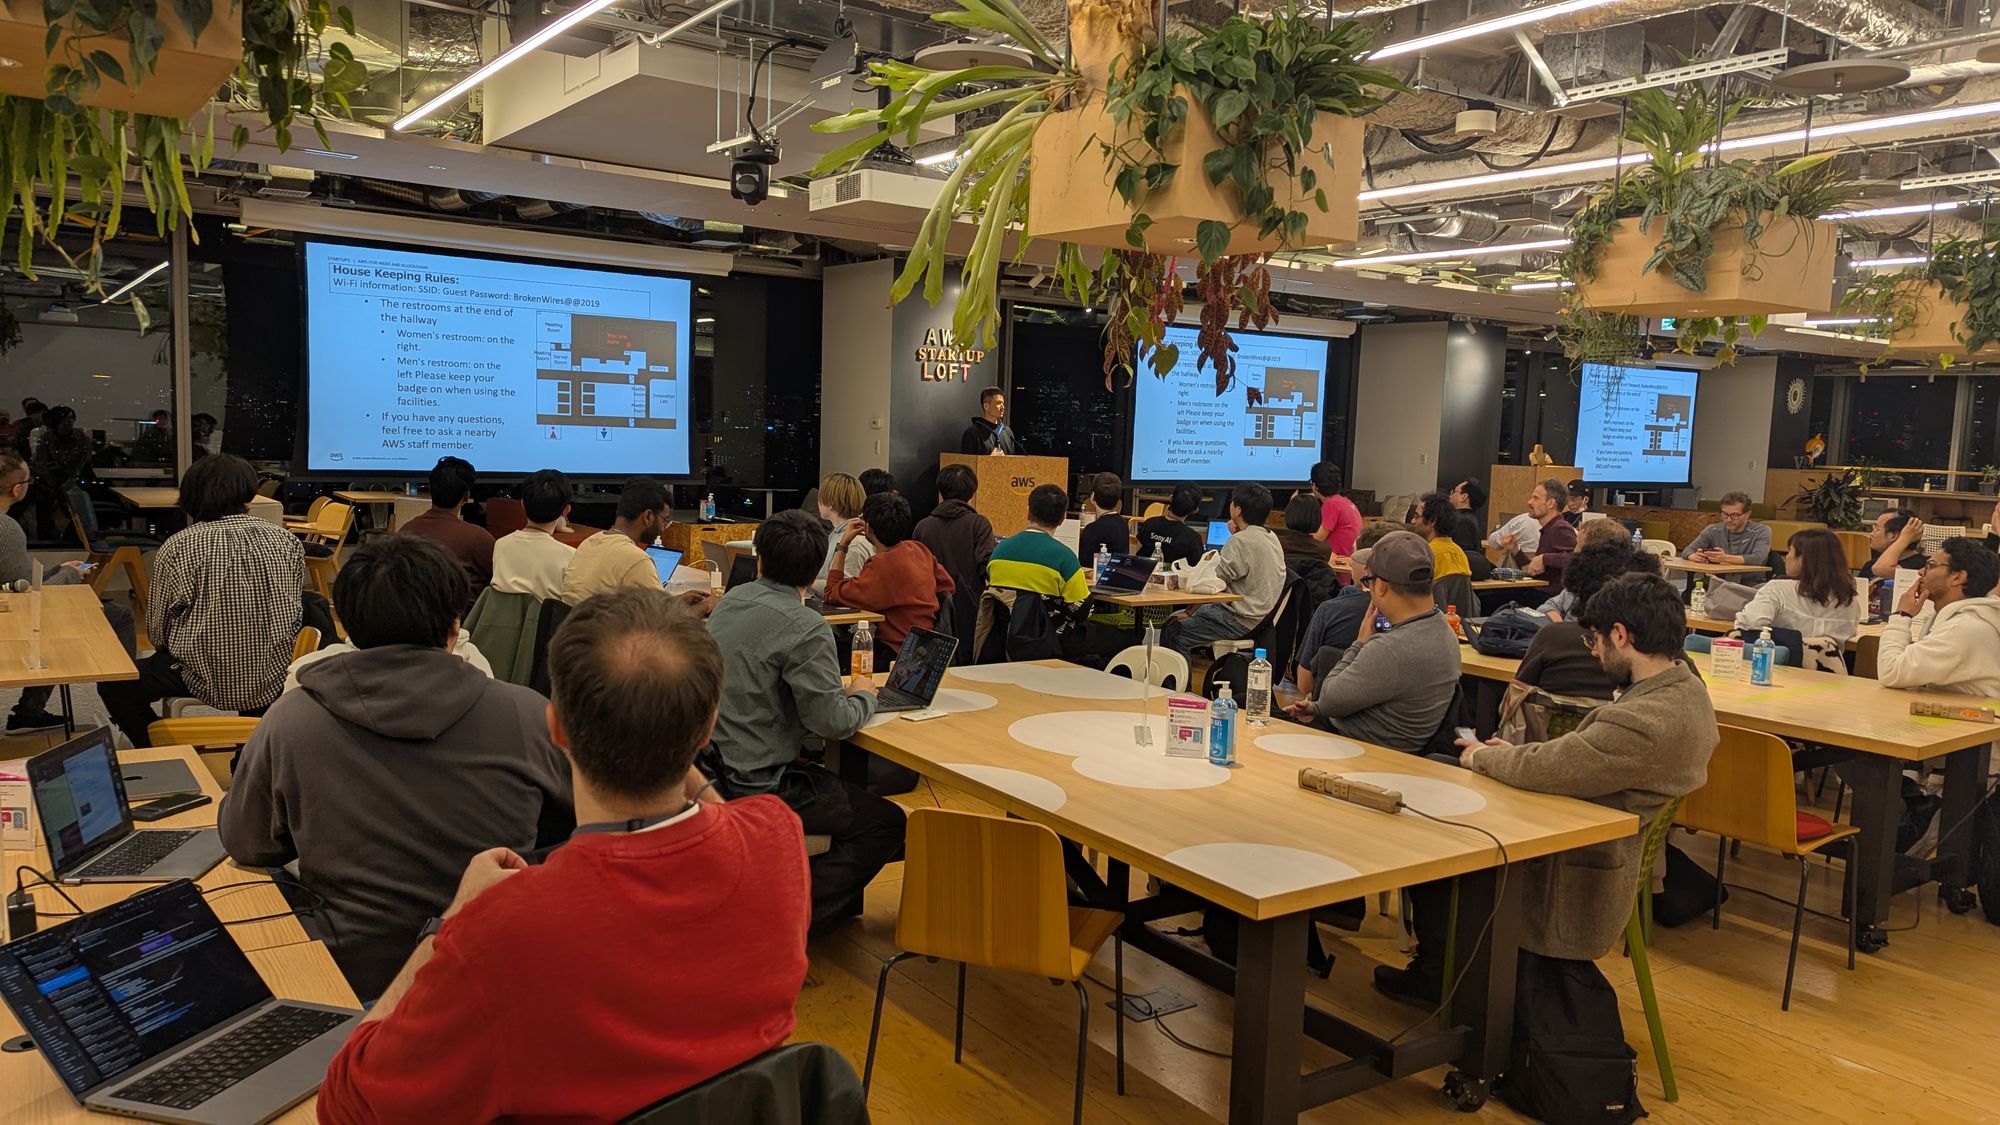
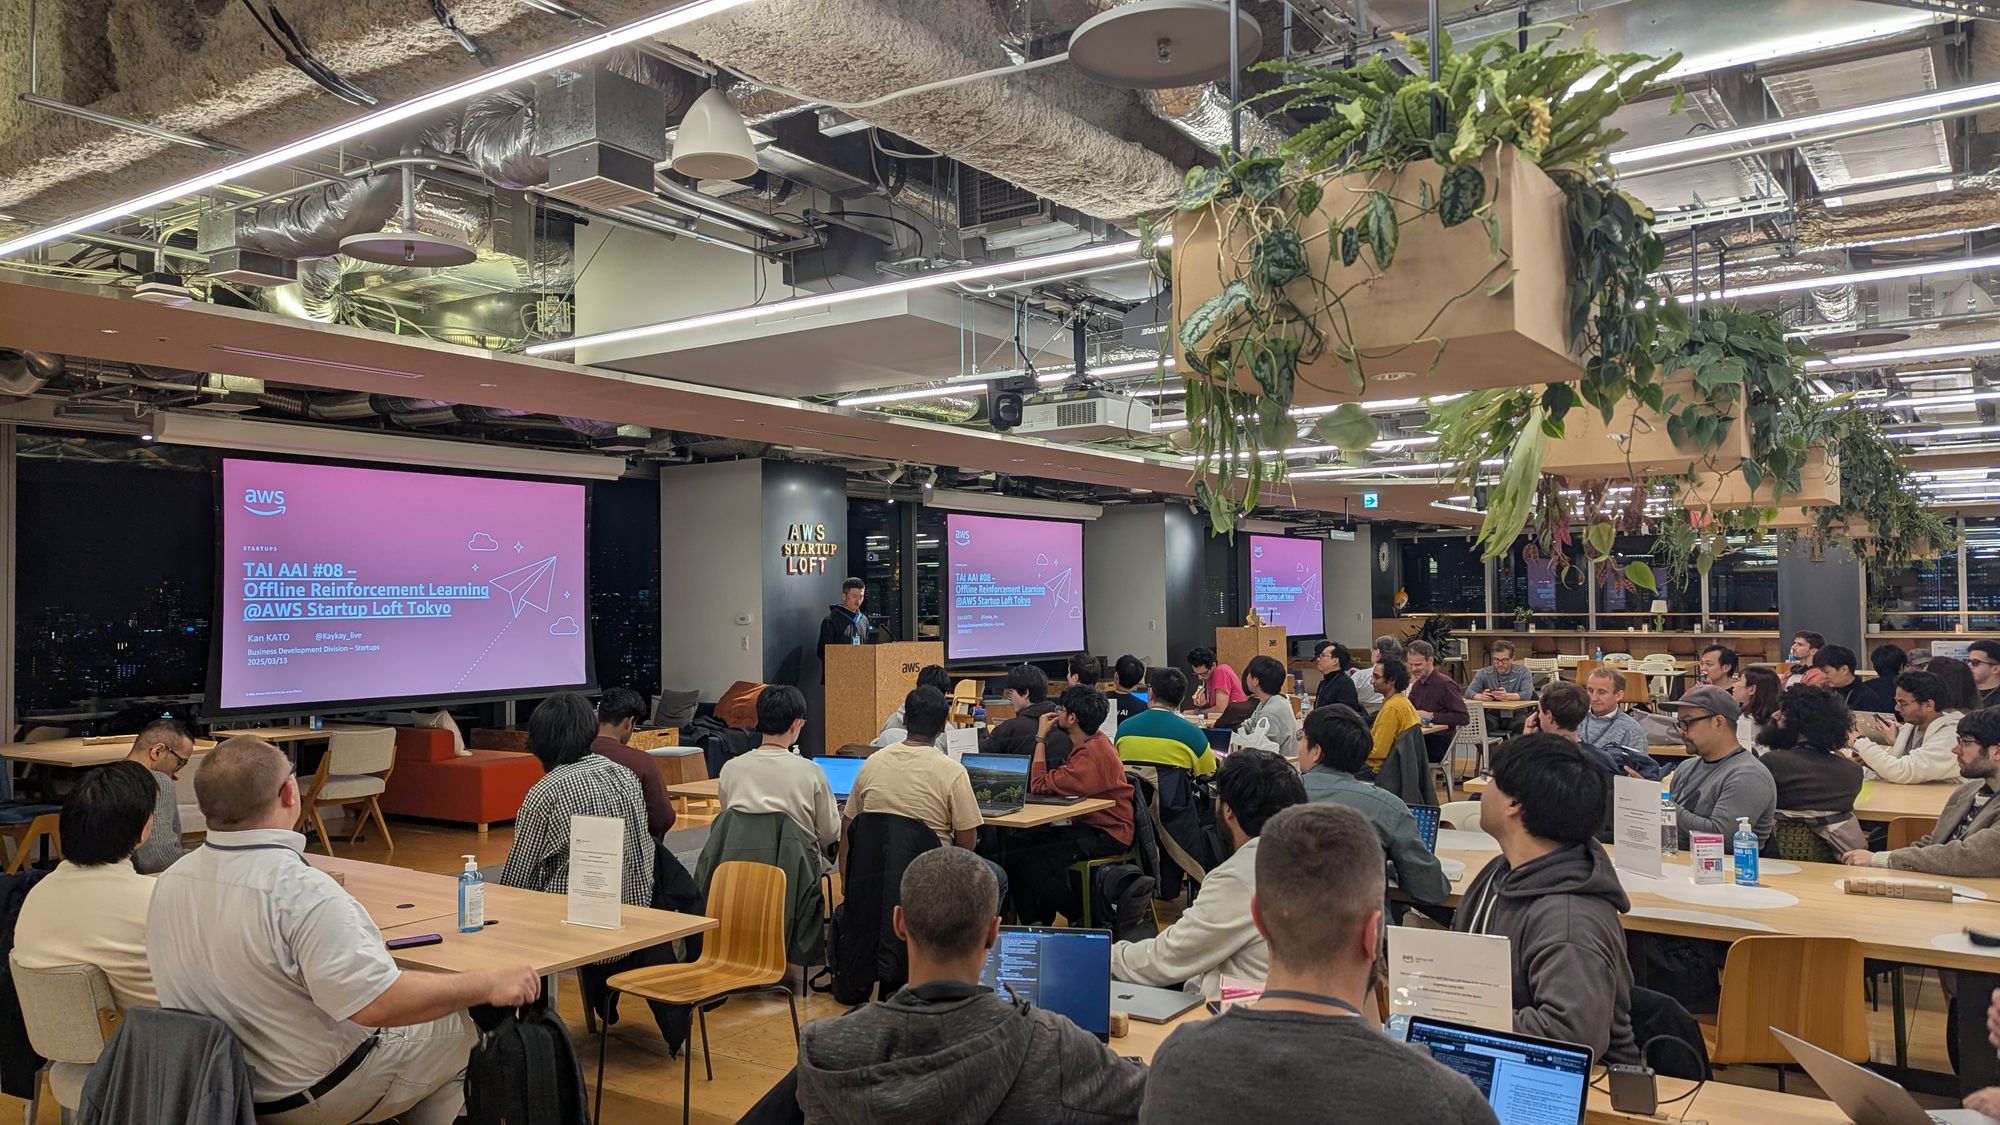
オフライン強化学習は、本番環境で試行錯誤せず、既存の記録から方策を学びます。探索が高価または危険な分野では魅力的です。Tokyo AIのイベントでJohannes Ackermann氏とShivakanth Sujit氏は、その記録から何が分かり、何が分からないかを考える材料を示しました。
ログがどう作られたかを問う
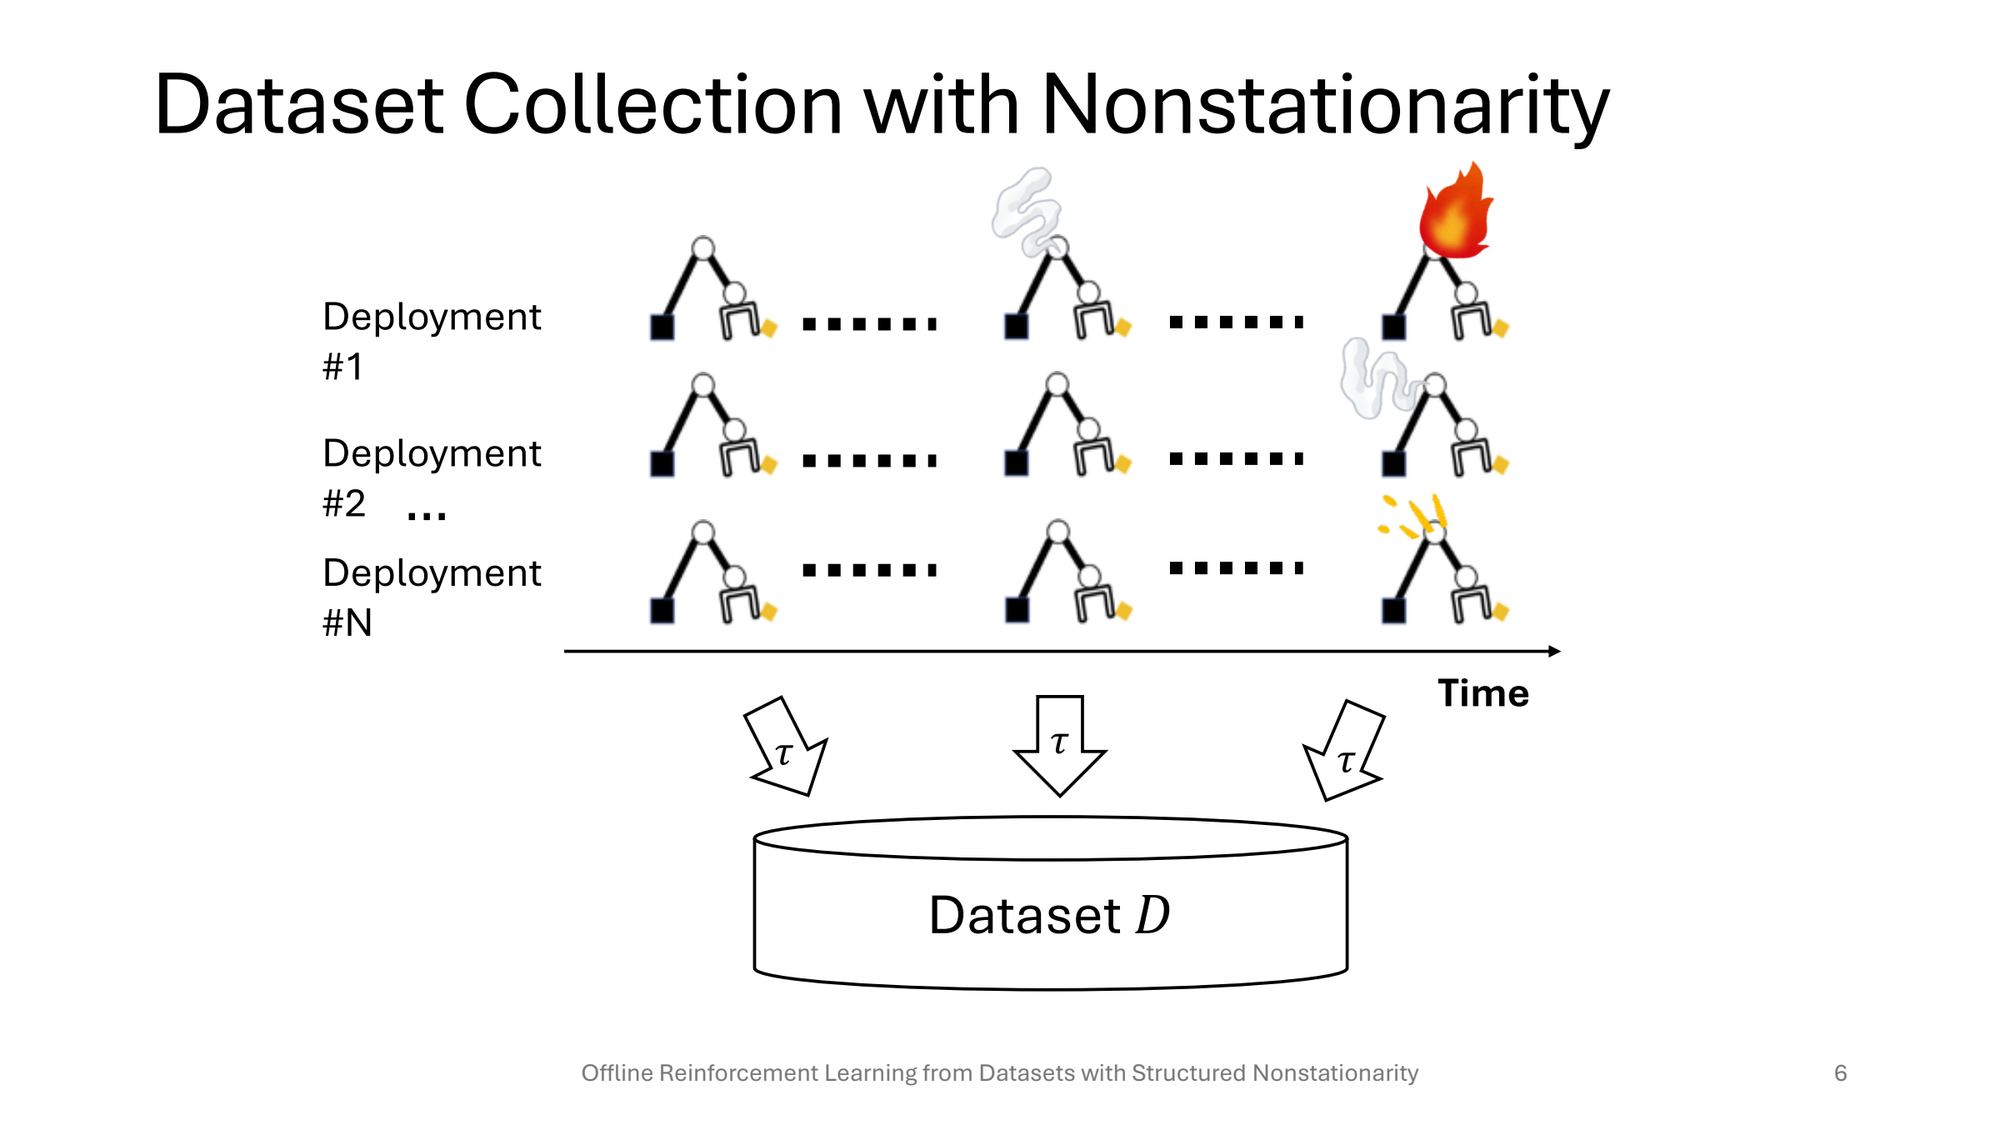
Johannes氏の発表は、条件が構造的に変化するデータセットを扱いました。ログは、可能な行動と結果を中立に集めた標本ではありません。ある方策の下で作られ、その間に運用条件が変わったかもしれません。担当者、設備、目的が変わっていたなら、すべてを一つの安定した工程として学習するのは危険です。学習前に、どの期間の、どの方策の、どんな状況のデータかを整理します。
過去の方策がほとんど選ばなかった行動については、その結果をログから直接観測できません。モデルが自信を示す領域ほど、裏付けが薄い場合もあります。学習時の点数だけで本番の安全性を判断せず、候補方策の範囲とデータのカバー率を確認します。
評価方法も評価する
Shivakanth氏は、サンプル効率とオフライン強化学習の比較方法を取り上げました。データ量が変わるとき、同じ回数の勾配更新で学習させるだけでは公平な比較にならない可能性があります。何を固定し、何の費用を測るかを明示しなければ、試験設定の偶然で手法を選んでしまいます。
倉庫の搬送経路を説明用の例として考えます。通常時のログは多くても、通路の閉鎖や設備故障は少ないかもしれません。研究段階では候補方策を比べ、データの弱い領域を見つけ、慎重な検証を設計できます。過去データの再生で良い結果が出ただけで本番へ投入すべきではありません。どの状況で追加データや人の管理が必要か分かることも、実証の成果です。
Tokyo AIは、Foundry Labsが運営する日本の開発者、研究者、ビジネスリーダーのコミュニティです。イベントページもご覧ください。
Johannes Ackermann氏とShivakanth Sujit氏の講演資料は、ご希望に応じてご案内できます。お問い合わせフォームからイベント名と登壇者名をお知らせください。
登壇者
- Johannes Ackermann:東京大学のオフライン強化学習研究者。
- Shivakanth Sujit:強化学習の評価研究者。