Foundry Labs / コミュニティから
vLLMの本番運用:推論性能と品質を業務負荷で評価する
目次
推論性能は、モデル単体の性質ではありません。どの入力を、どのハードウェアで、どれだけ同時に処理するかによって変わります。一件のデモが速くても、本番のサービスが必要とする品質と応答時間を満たすとは限りません。
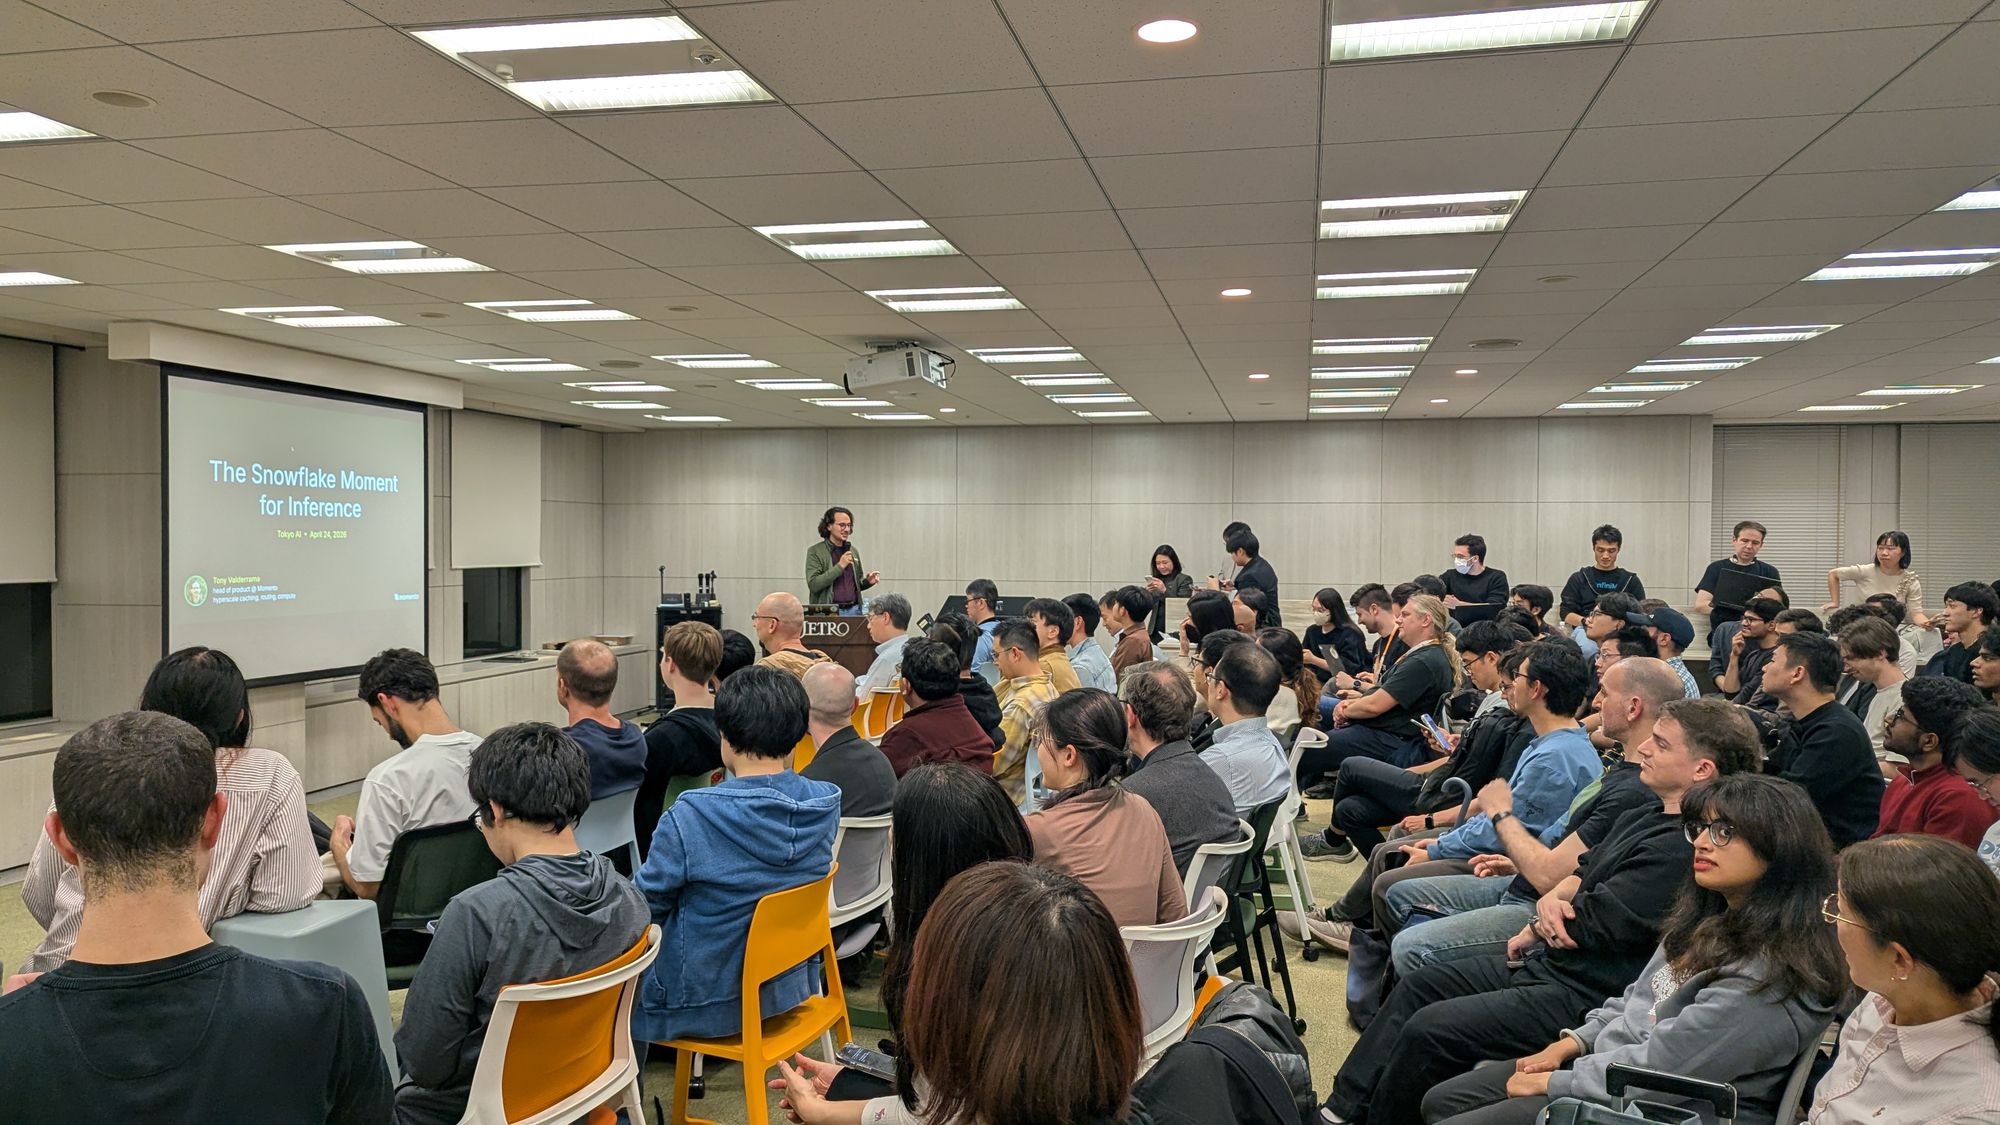
2026年4月24日のTokyo AIイベント「A vLLM Deep Dive」では、分散推論、KVキャッシュ、圧縮、本番運用が取り上げられました。これらを結び付ける問いは、最適化の効果を実際の業務負荷でどう判断するかです。
ユーザーが何を待っているかを分ける
Shisa.AIのCTO兼共同創業者、Leonard Lin氏は、最初のトークンまでの時間、出力トークン当たりの時間、全体の処理量、品質を分けて評価しています。
対話型の画面では、出力が始まるまで長く待たされると使いにくくなります。一方、夜間の一括処理なら、開始の速さよりも期限内に全件を終えられることが重要かもしれません。長い回答では、書き始めが速くても完了までの時間が問題になります。「毎秒何トークン」という一つの値だけでは、これらを判断できません。
Lin氏は入力と出力の長さを含む業務データの分布や、同時実行数を変えた評価を重視しています。短い質問から長い回答を生成する仕事と、長い文書から数項目を抽出する仕事では、負荷のかかり方が異なります。
キャッシュには、計算だけでなく転送の設計がある
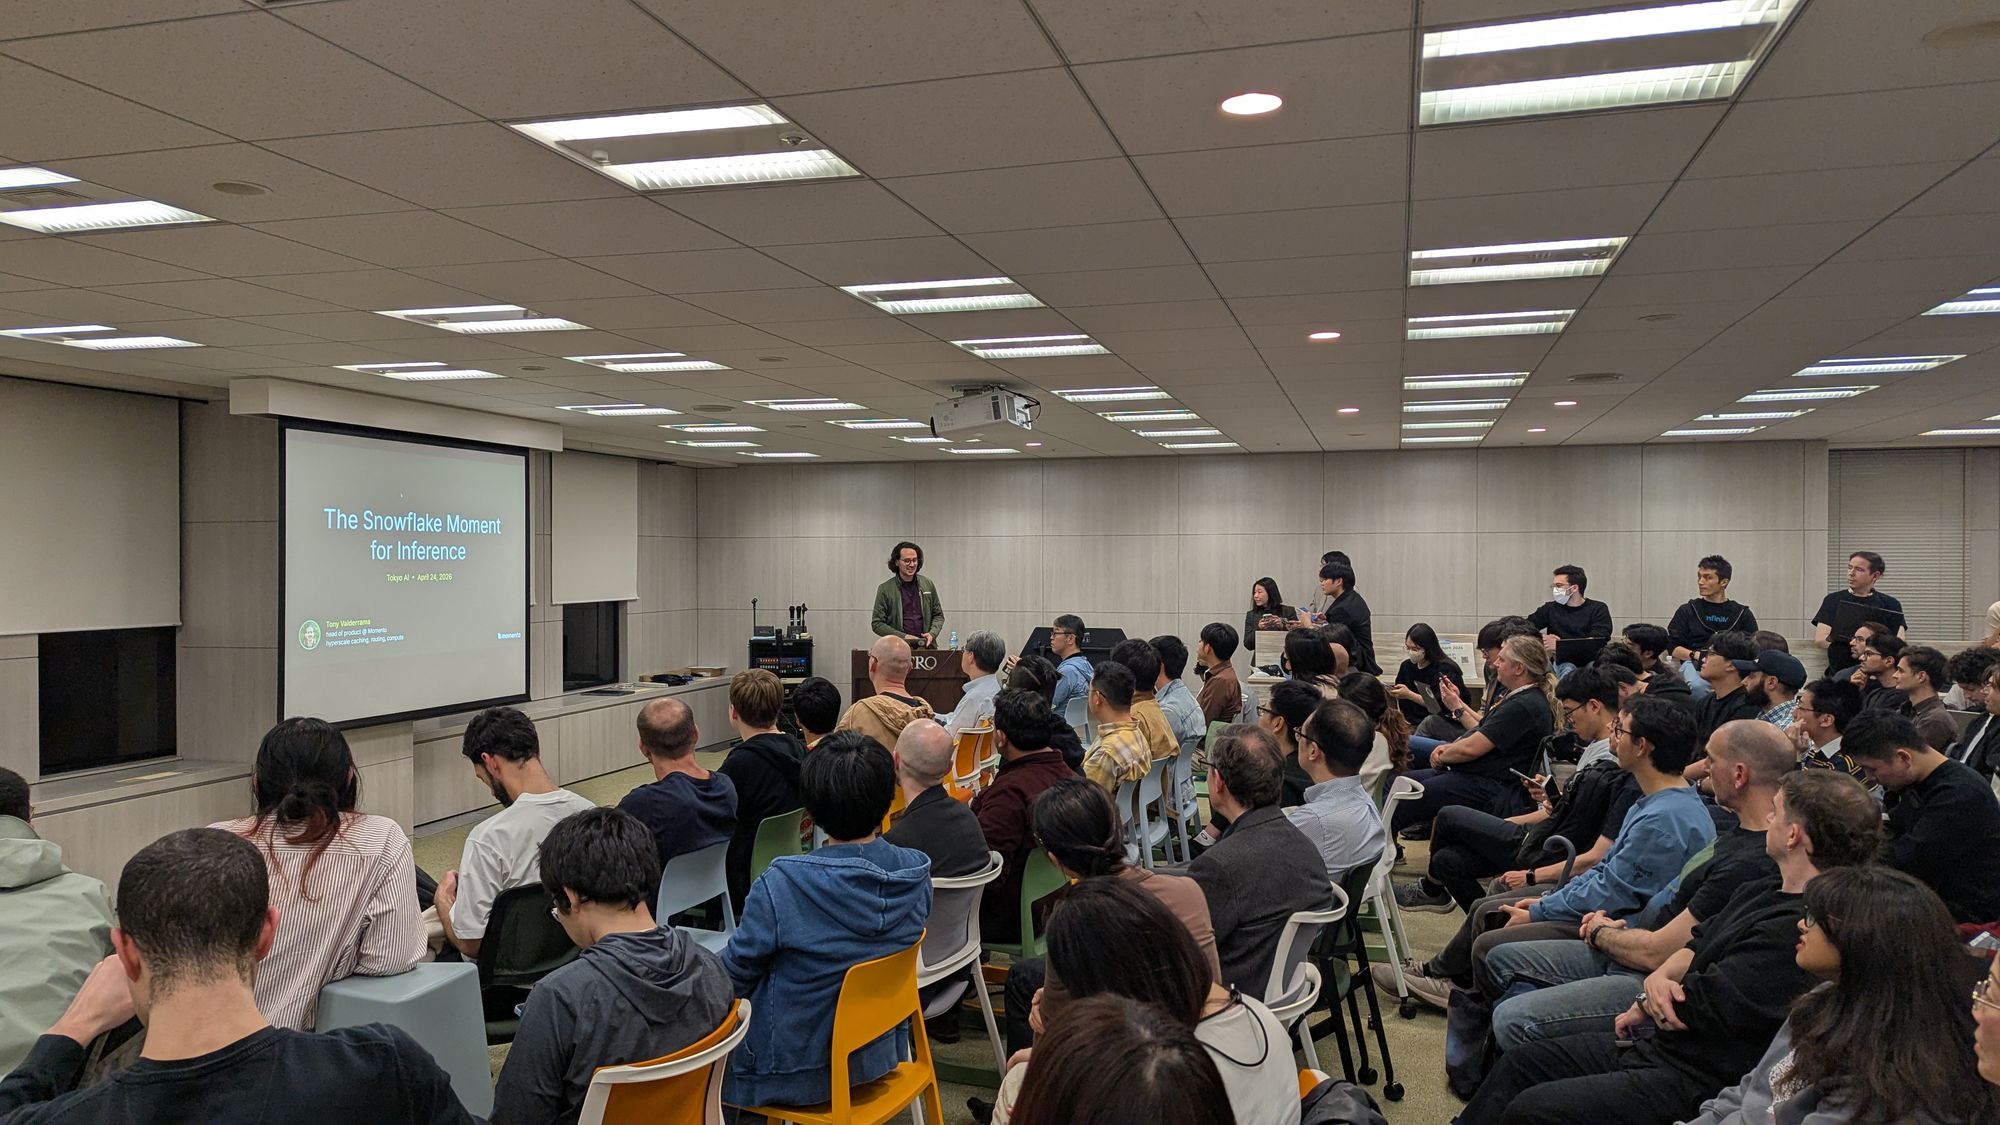
MomentoのHead of Product、Tony Valderrama氏は、ストレージと計算を分離する視点からKVキャッシュを説明しています。KVキャッシュは注意機構の中間状態を保持し、計算の一部を繰り返さずに済むようにする仕組みです。講演ではローカルな保存、実行系の間での共有、離れた場所への永続化という構成を扱います。
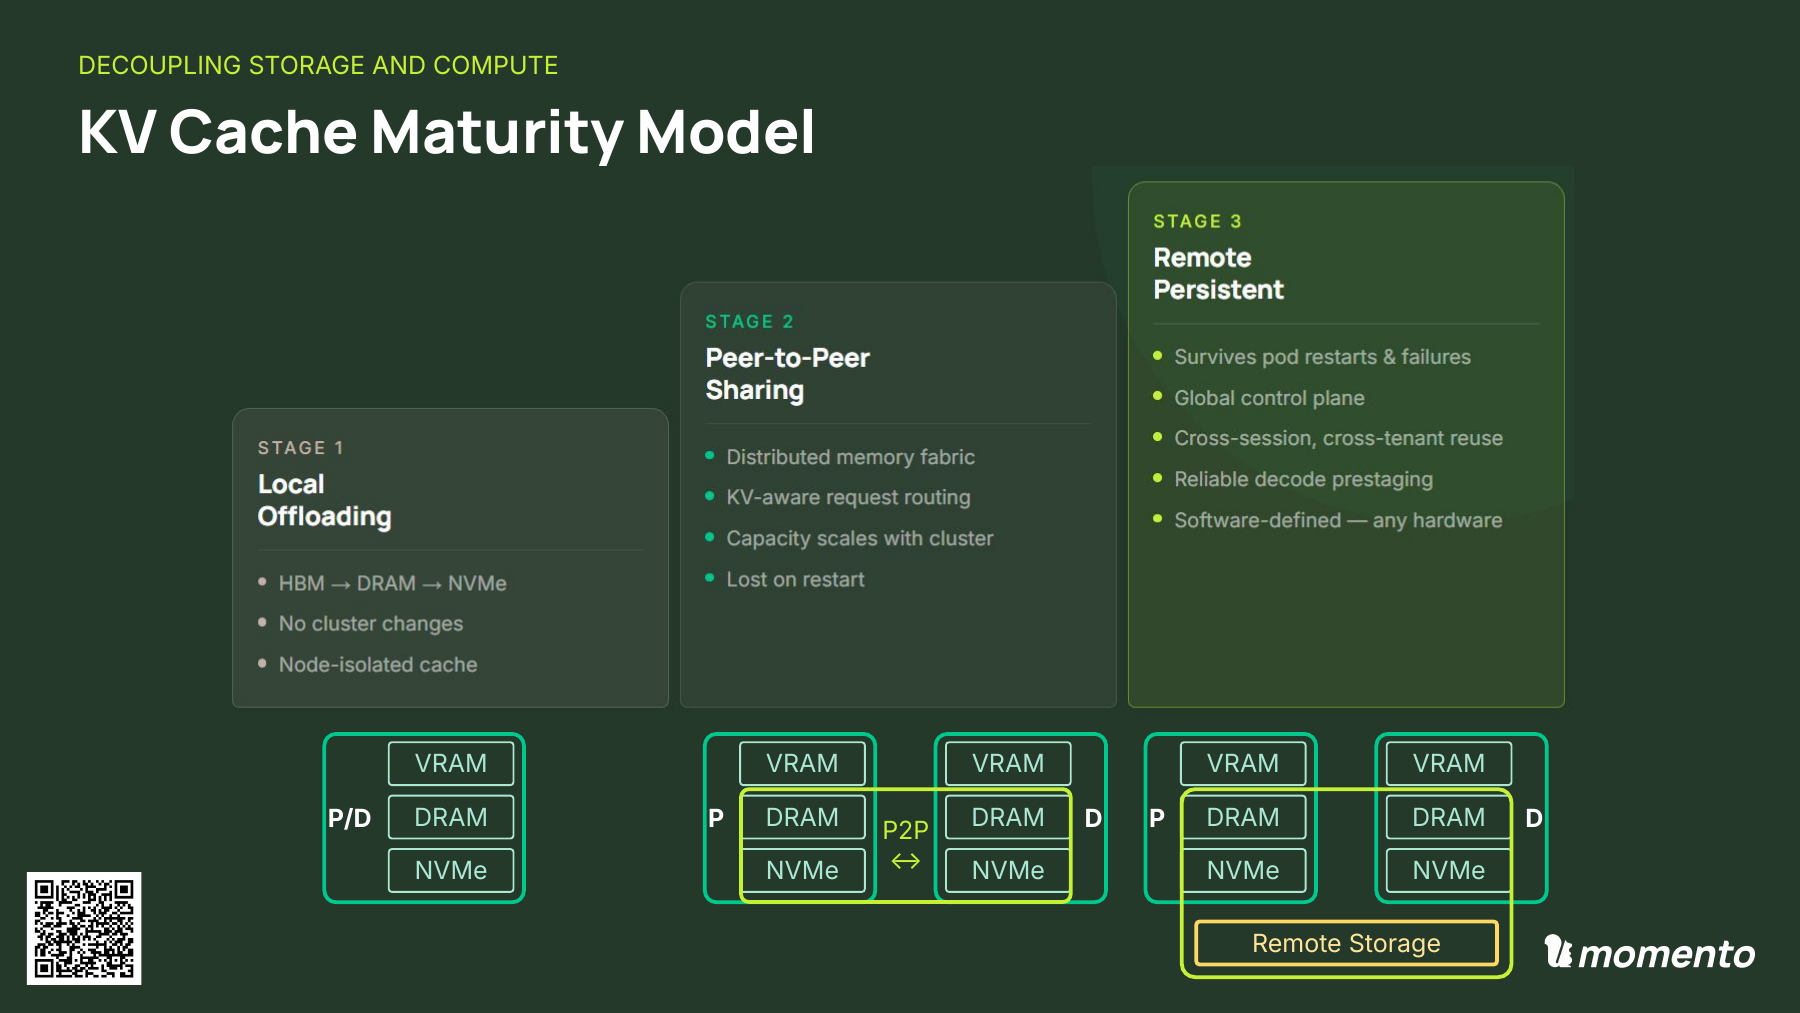
計算済みの状態を再利用できても、そのデータを運ぶ時間がかかれば効果は変わります。容量だけでなく、転送量、帯域、データの所在、キャッシュが使えない場合の負荷を考える必要があります。
入力を処理するprefillと、続きを生成するdecodeでは、必要な資源も異なります。両者の分離は資源配分の選択肢を増やす一方で、転送や調整を追加します。すべてのシステムが導入すべき構成ではなく、実際の処理に照らして検証する対象です。
圧縮の効果は、品質と合わせて読む
Lin氏は、精度形式を比較する際に、処理性能と出力品質を並べて示しています。メモリ使用量が減っても、業務に必要な出力が保たれるかは別に確認しなければなりません。
また、モデルの重みの圧縮と、キャッシュ状態の保存・転送方法の変更では、対象となる資源も追加される処理も違います。省メモリ化に価値があっても、特定の負荷で最速になるとは限りません。
日本語の業務なら、実際に扱う固有名詞、書式、要約、翻訳などを評価に含めます。一般的なスコアが高くても、重要な項目を落とすなら、その業務には不十分です。
Foundryの視点:本番で動かすサービスを測る
日本語の問い合わせ履歴を要約し、短い返信案を作るサービスを仮の例として考えます。最初のPoCは整った会話数件で成立しても、本番の構成を選ぶには、長短の履歴、繰り返し使う文脈、専門用語、繁忙時の負荷を含めた評価が必要です。
まず業務品質を満たす基準構成を作り、同時実行数、精度形式、キャッシュ、ハードウェアなどを一つずつ変えます。品質が保たれるか、開始までの待ち時間と完了時間がどう変わるか、資源をどれだけ使うかを記録します。結果にはモデル、ソフトウェア版、ハードウェア、測定条件を残します。
処理待ちが増えたときの動作も決めます。待たせるのか、新しい要求を断るのか、別途評価済みの代替手段を使うのか。実行系の再起動後にどれだけで戻れるかも、サービスとしての使いやすさに関わります。
Foundry Labsの本番AIシステム開発につながるのは、数字の大きい構成を選ぶことだけではなく、業務の条件を満たす理由を説明し、後から見直せる状態を作ることです。実装時の計測項目は、vLLMの最新の公式ドキュメントで確認できます。
出典・関連情報
本記事は、A vLLM Deep Dive - Distributed Inference, KV Cache Evolution, and Model Compressionのイベント案内と上記の講演をもとに構成しています。Tokyo AI(TAI)は研究者、エンジニア、企業をつなぐコミュニティです。Foundry Labsのコミュニティ活動もご覧ください。
Tun Jian Tan、Tony Valderrama、Leonard Linの登壇資料をご希望の方は、お問い合わせフォームより、イベント名と登壇者名を添えてご連絡ください。
本記事で取り上げた登壇者
Tun Jian Tan。Embedded LLMのAI Engineer、vLLMコミッター。vLLMの開発動向をテーマに登壇。 LinkedIn
Tony Valderrama。MomentoのHead of Product。vLLMのKVキャッシュの進化をテーマに登壇。 LinkedIn
Leonard Lin。Shisa.AI共同創業者・CTO。多言語モデルと本番推論に取り組む。 LinkedIn
記事一覧